MOSS-TTS

开源语音和声音生成模型家族,覆盖长语音、多说话人对话、音效、实时TTS等多种场景,由MOSI.AI和OpenMOSS团队推出。亮点在于提供从8B到1.7B的多个模型(MOSS-TTS、TTSD、VoiceGenerator、SoundEffect等),采用Delay/Local/Realtime架构,支持31种语言,并在llama.cpp和SGLang上实现高效推理,在Seed-TTS-eval等基准上达到开源SOTA,社区活跃且持续更新。
README
MOSS-TTS 家族





MOSS‑TTS 家族是由 MOSI.AI 和 OpenMOSS 团队 开发的开源 语音与声音生成模型家族。专为 高保真度、高表现力 和 复杂真实场景 设计,覆盖稳定的长语音、多说话人对话、音色/角色设计、环境音效以及实时流式 TTS。
新闻
- 2026.5.26: 🚀 发布 MOSS-SoundEffect-v2.0,一个基于 DiT 主干网络与 Flow Matching 目标 的新型文生音频模型,可生成 48 kHz 的双语音效,最长 30 秒 —— 请参见
moss_soundeffect_v2/。 - 2026.5.26: 🚀 发布 MOSS-TTS-v1.5,在提供语言标签时具有更强的多语言合成能力,更稳定的音色克隆,更好的长参考-短文本克隆,跟随标点的韵律控制,以及通过
[pause X.Ys]实现显式停顿控制。 - 2026.5.6: 🚀 MOSS-TTS 和 MOSS-Audio-Tokenizer 现已支持
mlx-audio。详情请访问 mlx-audio GitHub 仓库。 - 2026.4.29: 📝 MOSS-TTS 2.0 即将发布!我们通过 需求收集表单 收集 TTS 反馈、建议和功能需求。
- 2026.4.13: 🚀 MOSS-TTS-Nano,我们约 1 亿参数的模型现已可用!它支持多语言音色克隆、48 kHz 立体声输入/输出,以及仅需 4 个 CPU 核心的流式输出。查看 GitHub 仓库 和我们的 博客 了解更多详情。
- 2026.3.31: 📄 我们的 MOSS-TTSD 和 MOSS-VoiceGenerator 技术报告已在 arXiv 上线!
- 2026.3.26: 📘 新增关于微调 MOSS-TTS-Realtime 的教程。
- 2026.3.20: 📄 我们的 技术报告 已在 arXiv 上线!
- 2026.3.18: 🚀 在配套仓库
OpenMOSS/llama.cpp中新增了对 MOSS-TTS 的一等公民llama.cpp实现,包括端到端文档和可运行的 GGUF 骨干网络推理 + ONNX 音频编解码解码流程。请参见 一等公民 e2e 指南。 - 2026.3.16: 📘 新增关于微调 MossTTSLocal 架构的教程,适用于 MOSS-TTS-Local-Transformer!
- 2026.3.12: 🚀 为
MossTTSDelay架构增加 SGLang 后端支持,实现了 MOSS-TTS (Delay) 和 MOSS-SoundEffect 的高效推理,生成吞吐量提升约 3 倍! - 2026.3.11: 📘 新增关于微调 MossTTSDelay 架构的教程,适用于 MOSS-TTS(Delay)、MOSS-TTSD、MOSS-VoiceGenerator 和 MOSS-SoundEffect!
- 2026.3.10: ⚡️ 显著优化了 llama.cpp 推理管线的显存占用。现在 8B 模型可以适配 8GB GPU!
- 2026.3.4: 🚀 新增 无 PyTorch 推理支持——通过 llama.cpp + ONNX Runtime 实现轻量级设备端部署。量化 GGUF 权重 已在 OpenMOSS-Team/MOSS-TTS-GGUF 发布,ONNX 音频 tokenizer 已在 OpenMOSS-Team/MOSS-Audio-Tokenizer-ONNX 发布。详情请参见 llama.cpp 后端。
- 2026.3.4: 🎉 我们在 🦞 OpenClaw 的 ClawHub 中添加了 MOSS-TTS 技能:feishu-voice-tts 和 moss-tts-voice。
- 2026.2.10: 🎉🎉🎉 我们发布了 MOSS-TTS 家族。查看我们的 博客 了解更多详情!我们的 Huggingface Space 地址如下:MOSS-TTS、MOSS-TTSD-v1.0、MOSS-VoiceGenerator。
演示
目录
- MOSS-TTS 家族
简介
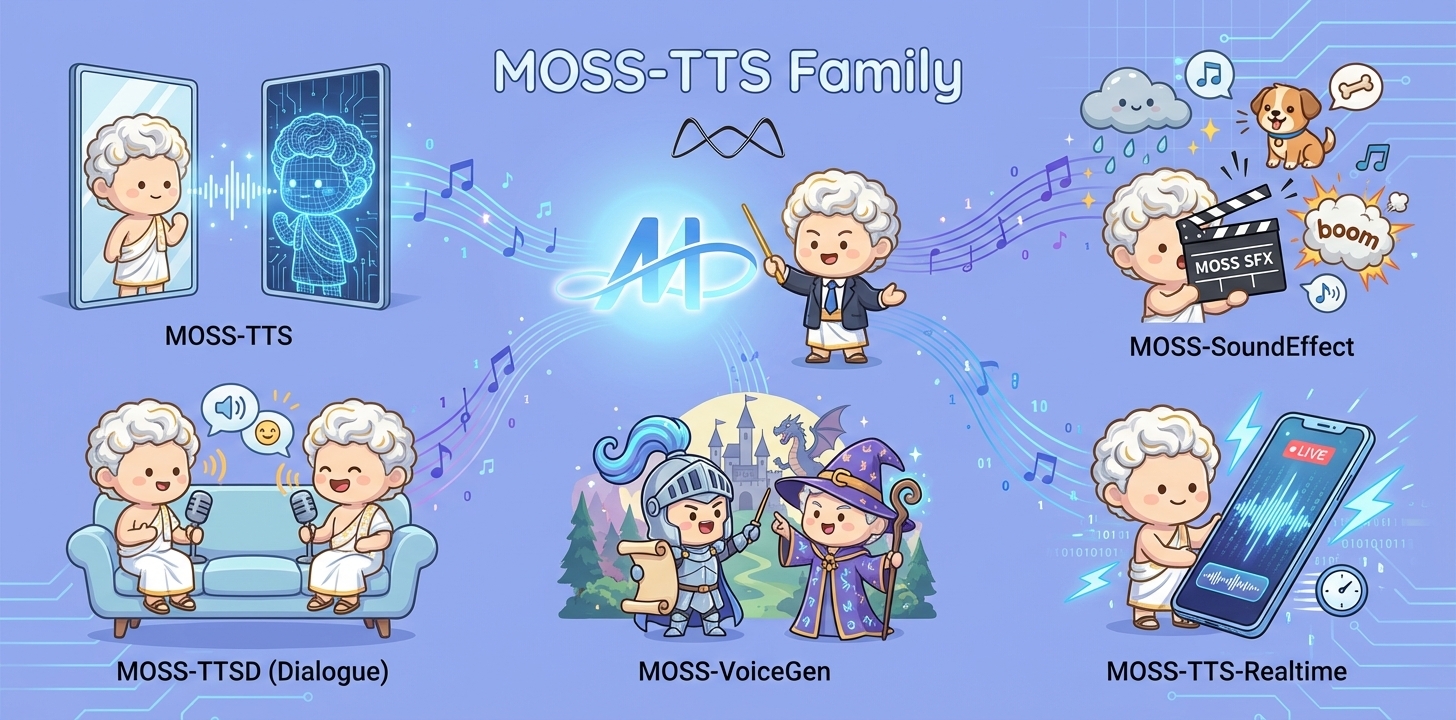
当一段音频需要 听起来像真人、每个字都准确发音、根据内容切换说话风格、在数十分钟内保持稳定,并且 支持对话、角色扮演和实时交互 时,单一的 TTS 模型往往不够。MOSS‑TTS 家族 将工作流程拆解为五个生产就绪的模型,可以独立使用,也可以组合成完整管线。
- MOSS‑TTS:旗舰生产模型,具有高保真度和最优零样本音色克隆。支持 长语音生成、对拼音、音素和时长的细粒度控制,以及 多语言/代码切换合成。
- MOSS‑TTSD:用于表达性、多说话人和超长对话的口语对话生成模型。新的 v1.0 版本 在 客观指标上达到行业领先水平,并在主观评估中 超越了豆包、Gemini 2.5-pro 等顶尖闭源模型。详情请访问 MOSS-TTSD 仓库。
- MOSS‑VoiceGenerator:一个开源的音色设计模型,能够直接从文本提示生成多样化的音色和风格,无需任何参考语音。它将音色设计、风格控制和合成统一起来,可以独立使用,也可以作为下游 TTS 的设计层。其性能在 arena 评分中超越了其他顶级音色设计模型。
- MOSS‑TTS‑Realtime:用于实时语音智能体的多轮上下文感知模型。它使用增量式合成确保自然连贯的回复,非常适合与文本模型搭配构建低延迟语音智能体。MOSS-TTS-Realtime 的 TTFB(首字节时间)达到 180 ms,$T_{\text{LLM-first-sentence}} + T_{\text{MOSS-TTS-Realtime-TTFB}}$ 为 377 ms。
- MOSS‑SoundEffect:专注于 音效生成 的内容创作模型,覆盖类别广泛且时长可控。可生成自然环境、城市场景、生物声、人类动作和音乐片段等音效,适用于电影、游戏和交互式体验。
模型架构
我们训练了 MossTTSDelay 和 MossTTSLocal 作为同一训练/评估设置下的互补基线:Delay 强调长上下文稳定性、推理速度和生产就绪性,而 Local 强调轻量灵活性,为面向流的系统提供强劲的客观性能。两者共同为部署和研究提供了可复现的参考。
MossTTSRealtime 不是第三个对比基线;它是面向语音智能体的能力驱动设计。通过建模来自先前文本和用户声学的多轮上下文,它在各轮次之间提供低延迟流式语音,并保持连贯和音色一致。
| 架构 | 核心机制 | 架构详情 |
|---|---|---|
MossTTSDelay |
多头部并行 RVQ 预测 + 延迟模式调度 |  |
MossTTSLocal |
时间同步 RVQ 块 + 深度 Transformer | |
MossTTSRealtime |
层级文本–音频输入用于实时合成 | |
已发布模型
| 模型 | 架构 | 参数量 | 模型卡片 | Hugging Face | ModelScope |
|---|---|---|---|---|---|
| MOSS-TTS-v1.5 | MossTTSDelay |
8B | |
 |
|
| MOSS-TTS 1.0 | MossTTSDelay |
8B | |
|
|
| MOSS-TTS-Local-Transformer | MossTTSLocal |
1.7B | |
|
|
| MOSS‑TTSD‑V1.0 | MossTTSDelay |
8B | |
|
|
| MOSS‑VoiceGenerator | MossTTSDelay |
1.7B | |
|
|
| MOSS‑SoundEffect | MossTTSDelay |
8B | |
|
|
| MOSS‑SoundEffect‑v2.0 | MossSoundEffectPipeline |
1.3B DiT | |
|
|
| MOSS‑TTS‑Realtime | MossTTSRealtime |
1.7B | |
|
|
支持的语言
MOSS-TTS-v1.5 目前支持 31 种语言。它保留了 MOSS-TTS 1.0 支持的 20 种语言,并通过多语言持续训练扩展到粤语、荷兰语、芬兰语、印地语、马其顿语、马来语、罗马尼亚语、斯瓦希里语、他加禄语、泰语和越南语。
MOSS-TTSD 和 MOSS-TTS-Realtime 的支持语言范围请参考各自的模型卡片。
| 语言 | 代码 | 旗帜 | 语言 | 代码 | 旗帜 | 语言 | 代码 | 旗帜 |
|---|---|---|---|---|---|---|---|---|
| 中文 | zh | 🇨🇳 | 粤语 | yue | 🇭🇰 | 英语 | en | 🇺🇸 |
| 阿拉伯语 | ar | 🇸🇦 | 捷克语 | cs | 🇨🇿 | 丹麦语 | da | 🇩🇰 |
| 荷兰语 | nl | 🇳🇱 | 芬兰语 | fi | 🇫🇮 | 法语 | fr | 🇫🇷 |
| 德语 | de | 🇩🇪 | 希腊语 | el | 🇬🇷 | 希伯来语 | he | 🇮🇱 |
| 印地语 | hi | 🇮🇳 | 匈牙利语 | hu | 🇭🇺 | 意大利语 | it | 🇮🇹 |
| 日语 | ja | 🇯🇵 | 韩语 | ko | 🇰🇷 | 马其顿语 | mk | 🇲🇰 |
| 马来语 | ms | 🇲🇾 | 波斯语(法尔西语) | fa | 🇮🇷 | 波兰语 | pl | 🇵🇱 |
| 葡萄牙语 | pt | 🇵🇹 | 罗马尼亚语 | ro | 🇷🇴 | 俄语 | ru | 🇷🇺 |
| 西班牙语 | es | 🇪🇸 | 斯瓦希里语 | sw | 🇹🇿 | 瑞典语 | sv | 🇸🇪 |
| 他加禄语 | tl | 🇵🇭 | 泰语 | th | 🇹🇭 | 土耳其语 | tr | 🇹🇷 |
| 越南语 | vi | 🇻🇳 |
MOSS-TTS-v1.5
MOSS-TTS-v1.5 从 MOSS-TTS 1.0 继续训练而来。它保留了 v1.0 的主要能力,包括零样本音色克隆、长语音生成、Token 级时长控制、拼音/IPA 发音控制、多语言合成和代码切换。
与 MOSS-TTS 1.0 相比,v1.5 主要关注以下改进:
- 语言标签下更强的多语言合成:当语言已知时,在
processor.build_user_message(text=text, language="French")或等效 API 字段中设置语言。 - 更稳定的音色克隆:v1.5 提升了说话人相似度,并降低了多次生成之间的克隆方差。
- 更好的长参考-短文本克隆:v1.5 更可靠地处理参考音频远长于目标文本的情况。
- 更稳定的标点跟随韵律:v1.5 更紧密地遵循标点驱动的停顿,尤其是在长句中。
- 显式停顿控制:使用内敛停顿标记,例如
[pause 3.2s]。示例:我今天学习了一首中国的古诗,它的名字是[pause 3.2s]静夜思!。
快速开始
OpenClaw API 技能
我们在 🦞 OpenClaw 的 ClawHub 中添加了 MOSS-TTS 技能。您可以从 MOSI AI Studio 获取您的 API 密钥。
| 技能 | 描述 | 安装 |
|---|---|---|
feishu-voice-tts |
在飞书中发送语音消息 | clawhub install feishu-voice-tts |
moss-tts-voice |
调用 MOSS-TTS API 生成语音 | clawhub install moss-tts-voice |
环境搭建
我们建议使用干净、隔离的 Python 环境,搭配 Transformers 5.0.0,以避免依赖冲突。
使用 Conda
conda create -n moss-tts python=3.12 -y
conda activate moss-tts
安装所有必需的依赖:
git clone https://github.com/OpenMOSS/MOSS-TTS.git
cd MOSS-TTS
pip install --extra-index-url https://download.pytorch.org/whl/cu128 -e ".[torch-runtime]"
使用 uv
# 先安装 uv:https://docs.astral.sh/uv/getting-started/installation/
git clone https://github.com/OpenMOSS/MOSS-TTS.git
cd MOSS-TTS
uv venv --python 3