VoxCPM

无分词器的多语言语音合成系统,基于扩散自回归架构直接生成连续语音表征,最新2B参数模型支持30种语言、语音设计(文本描述创造新声音)和可控语音克隆,输出48kHz高保真音频。相比同类开源TTS(如CosyVoice、F5-TTS),在Seed-TTS-eval和MLS多语言测试中达到领先水平,且Apache-2.0协议可商用。支持RTX 4090实时推理、Nano-vLLM/vLLM-Omni生产部署,并提供SFT/LoRA微调能力。
README
VoxCPM2: 无分词器的TTS,用于多语言语音生成、创意声音设计与逼真克隆
English | 中文

 飞书
 Discord
VoxCPM 是一个无 tokenizer 的 Text-to-Speech 系统,通过端到端的扩散自回归架构直接生成连续语音表示,绕过离散 tokenization,实现高度自然且富有表现力的合成。
VoxCPM2 是最新的主要版本——一个 2B 参数的模型,在 超过 200 万小时 的多语言语音数据上训练,现在支持 30 种语言、声音设计、可控语音克隆 和 48kHz 录音室级音频输出。基于 MiniCPM-4 骨干。
✨ 亮点
- 🌍 30 语言多语种 — 直接输入支持的 30 种语言中的任何一种文本并合成,无需语言标签
- 🎨 声音设计 — 仅凭自然语言描述(性别、年龄、语气、情感、语速等)创造全新的声音,无需参考音频
- 🎛️ 可控克隆 — 从短参考片段克隆任意声音,并可选择风格引导来控制情感、语速和表达,同时保留原始音色
- 🎙️ 终极克隆 — 重现每一个声音细节:同时提供参考音频及其文本,模型从参考处无缝延续,忠实保留所有声音细节——音色、节奏、情感和风格(同 VoxCPM1.5)
- 🔊 48kHz 高质量音频 — 接受 16kHz 参考音频,通过 AudioVAE V2 的非对称编码/解码设计直接输出 48kHz 录音室级音频,内置超分辨率——无需外部上采样器
- 🧠 上下文感知合成 — 自动从文本内容推断合适的韵律和表现力
- ⚡ 实时流式 — 在 NVIDIA RTX 4090 上 RTF 低至 ~0.3,通过 Nano-vLLM 或 vLLM-Omni 加速后低至 ~0.13——官方 vLLM omni-modal 服务,支持 PagedAttention 和 OpenAI 兼容 API
- 📜 完全开源 & 商业可用 — 权重和代码在 Apache-2.0 许可下发布,可免费商用
阿拉伯语,缅甸语,中文,丹麦语,荷兰语,英语,芬兰语,法语,德语,希腊语,希伯来语,印地语,印尼语,意大利语,日语,高棉语,韩语,老挝语,马来语,挪威语,波兰语,葡萄牙语,俄语,西班牙语,斯瓦希里语,瑞典语,他加禄语,泰语,土耳其语,越南语
中文方言:四川话,粤语,吴语,东北话,河南话,陕西话,山东话,天津话,闽南话
新闻
- [2026.04] 🔥 我们发布了 VoxCPM2 — 2B 参数,30 种语言,声音设计 & 可控语音克隆,48kHz 音频输出! 权重 | 文档 | 在线体验
- [2025.12] 🎉 开源 VoxCPM1.5 权重,支持 SFT 和 LoRA 微调。 (🏆 #1 GitHub Trending)
- [2025.09] 🔥 发布 VoxCPM 技术报告。
- [2025.09] 🎉 开源 VoxCPM-0.5B 权重 (🏆 #1 HuggingFace Trending)
目录
🚀 快速开始
安装
pip install voxcpm
要求: Python ≥ 3.10 (<3.13), PyTorch ≥ 2.5.0, CUDA ≥ 12.0。详情见 快速开始文档。
Python API
🗣️ 文本到语音
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained(
  "openbmb/VoxCPM2",
  load_denoiser=False,
)

wav = model.generate(
    text="VoxCPM2 is the current recommended release for realistic multilingual speech synthesis.",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
print("saved: demo.wav")
如果你更倾向于先从 ModelScope 下载,可以使用:
pip install modelscope
from modelscope import snapshot_download
snapshot_download("OpenBMB/VoxCPM2", local_dir='./pretrained_models/VoxCPM2') # 指定本地目录保存模型

from voxcpm import VoxCPM
import soundfile as sf
model = VoxCPM.from_pretrained("./pretrained_models/VoxCPM2", load_denoiser=False)

wav = model.generate(
    text="VoxCPM2 is the current recommended release for realistic multilingual speech synthesis.",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
🎨 声音设计
从自然语言描述创建声音——无需参考音频。格式: 将描述放在 text 开头的括号中(例如 "(your voice description)The text to synthesize."):
wav = model.generate(
    text="(A young woman, gentle and sweet voice)Hello, welcome to VoxCPM2!",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("voice_design.wav", wav, model.tts_model.sample_rate)
🎛️ 可控语音克隆
上传参考音频。模型克隆音色,你仍然可以使用控制指令调整速度、情感或风格。
wav = model.generate(
    text="This is a cloned voice generated by VoxCPM2.",
    reference_wav_path="path/to/voice.wav",
)
sf.write("clone.wav", wav, model.tts_model.sample_rate)

wav = model.generate(
    text="(slightly faster, cheerful tone)This is a cloned voice with style control.",
    reference_wav_path="path/to/voice.wav",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("controllable_clone.wav", wav, model.tts_model.sample_rate)
🎙️ 终极克隆
提供参考音频及其精确文本,进行基于音频延续的克隆,重现每一个声音细节。为获得最大克隆相似度,将同一参考片段同时传递给 reference_wav_path 和 prompt_wav_path 如下所示:
wav = model.generate(
    text="This is an ultimate cloning demonstration using VoxCPM2.",
    prompt_wav_path="path/to/voice.wav",
    prompt_text="The transcript of the reference audio.",
    reference_wav_path="path/to/voice.wav", # optional, for better simliarity
)
sf.write("hifi_clone.wav", wav, model.tts_model.sample_rate)
import numpy as np

chunks = []
for chunk in model.generate_streaming(
    text="Streaming text to speech is easy with VoxCPM!",
):
    chunks.append(chunk)
wav = np.concatenate(chunks)
sf.write("streaming.wav", wav, model.tts_model.sample_rate)
CLI 使用
# 声音设计(无需参考音频)
voxcpm design \
  --text "VoxCPM2 brings studio-quality multilingual speech synthesis." \
  --output out.wav

# 带有风格控制的可控语音克隆
voxcpm design \
  --text "VoxCPM2 brings studio-quality multilingual speech synthesis." \
  --control "Young female voice, warm and gentle, slightly smiling" \
  --output out.wav

# 语音克隆(参考音频)
voxcpm clone \
  --text "This is a voice cloning demo." \
  --reference-audio path/to/voice.wav \
  --output out.wav

# 终极克隆(提示音频 + 文本)
voxcpm clone \
  --text "This is a voice cloning demo." \
  --prompt-audio path/to/voice.wav \
  --prompt-text "reference transcript" \
  --reference-audio path/to/voice.wav \ # optional, for better simliarity
  --output out.wav

# 批量处理
voxcpm batch --input examples/input.txt --output-dir outs

# 帮助
voxcpm --help
Web 演示
python app.py --port 8808 # 然后在浏览器中打开:http://localhost:8808
使用 --device 选择运行设备:
python app.py --device auto
支持的值有 auto, cpu, mps, cuda, 和 cuda:N。在 Apple Silicon Mac 上,auto 会优先使用 MPS(如果可用)。
🚢 生产部署 (Nano-vLLM)
对于高吞吐量服务,请使用 Nano-vLLM-VoxCPM — 一个基于 Nano-vLLM 的专用推理引擎,支持并发请求和异步 API。
pip install nano-vllm-voxcpm
from nanovllm_voxcpm import VoxCPM
import numpy as np, soundfile as sf

server = VoxCPM.from_pretrained(model="/path/to/VoxCPM", devices=[0])
chunks = list(server.generate(target_text="Hello from VoxCPM!"))
sf.write("out.wav", np.concatenate(chunks), 48000)
server.stop()
在 NVIDIA RTX 4090 上 RTF 低至 ~0.13(标准 PyTorch 实现约为 ~0.3),支持批处理并发请求和 FastAPI HTTP 服务器。部署详情请参阅 Nano-vLLM-VoxCPM 仓库。
🏭 生产服务 (vLLM-Omni)
对于生产环境的多租户部署,请使用 vLLM-Omni — 官方 vLLM 项目的 omni-modal 扩展,原生支持 VoxCPM2。PagedAttention KV cache、连续批处理和即插即用的 OpenAI 兼容 /v1/audio/speech 端点。
# 从源码安装(最新主分支 — vllm-omni 正在快速迭代)
uv pip install vllm==0.19.0 --torch-backend=auto
git clone https://github.com/vllm-project/vllm-omni.git && cd vllm-omni
uv pip install -e .
其他平台(ROCm, XPU, MUSA, NPU)和 Docker 镜像请参阅 vLLM-Omni 安装指南。
# 启动 OpenAI 兼容的 TTS 服务器(--omni 启用 omni-modal 服务)
vllm serve openbmb/VoxCPM2 --omni --port 8000

# 从任何 OpenAI 客户端调用
curl http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"model":"openbmb/VoxCPM2","input":"Hello from VoxCPM2 on vLLM-Omni!","voice":"default"}' \
  --output out.wav
构建在上游 vLLM 调度器之上,支持批处理并发请求、流式块交付和多 GPU 部署。完整部署配方请参阅 VoxCPM2 示例。
📦 模型与版本
| VoxCPM2 | VoxCPM1.5 | VoxCPM-0.5B | |
|---|---|---|---|
| 状态 | 🟢 最新 | 稳定 | 遗留 |
| 骨干参数 | 2B | 0.6B | 0.5B |
| 音频采样率 | 48kHz | 44.1kHz | 16kHz |
| LM Token 率 | 6.25Hz | 6.25Hz | 12.5Hz |
| 语言 | 30 | 2 (zh, en) | 2 (zh, en) |
| 克隆模式 | 独立参考 & 延续 | 仅延续 | 仅延续 |
| 声音设计 | ✅ | — | — |
| 可控语音克隆 | ✅ | — | — |
| SFT / LoRA | ✅ | ✅ | ✅ |
| RTF (RTX 4090) | ~0.30 | ~0.15 | ~0.17 |
| Nano-VLLM 中的 RTF (RTX 4090) | ~0.13 | ~0.08 | ~0.10 |
| VRAM | ~8 GB | ~6 GB | ~5 GB |
| 权重 | 🤗 HF / MS | 🤗 HF / MS | 🤗 HF / MS |
| 技术报告 | 即将推出 | — | arXiv ICLR 2026 |
| 演示页面 | 音频样本 | — | 音频样本 |
VoxCPM2 构建在无 tokenizer、扩散自回归范式之上。模型完全在 AudioVAE V2 的潜在空间中运行,遵循四阶段流程:LocEnc → TSLM → RALM → LocDiT,实现丰富的表现力和 48kHz 原生音频输出。
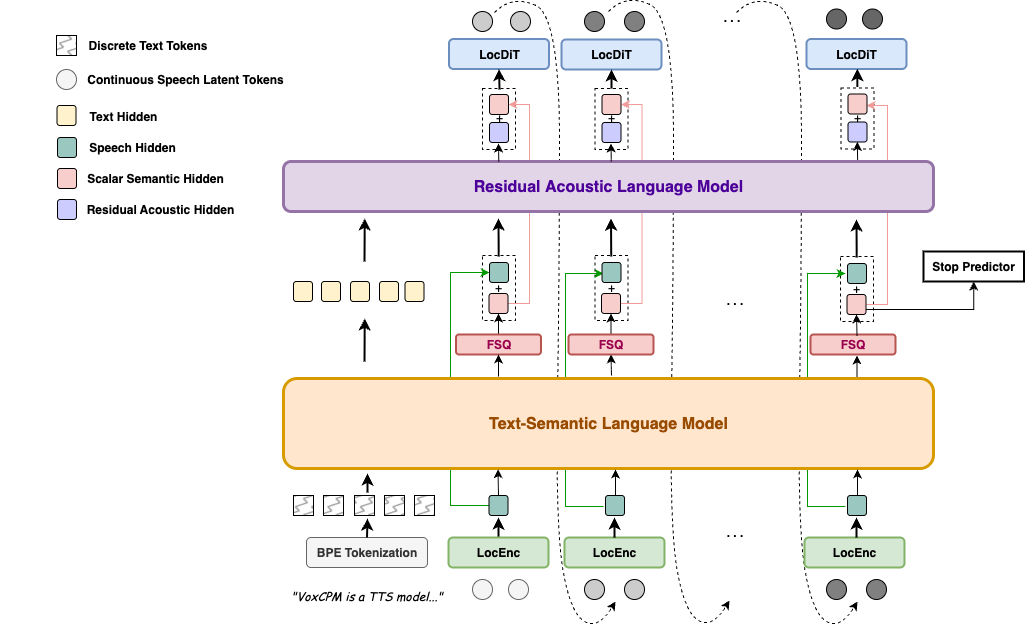
完整的架构细节、VoxCPM2 特定升级以及模型对比表,请参阅 架构设计。
📊 性能
VoxCPM2 在公开的零样本和可控 TTS 基准测试中达到了最先进或可比的结果。
Seed-TTS-eval
Seed-TTS-eval WER(⬇)&SIM(⬆) 结果 (点击展开)| 模型 | 参数量 | 开源 | test-EN | test-ZH | test-Hard | |||
|---|---|---|---|---|---|---|---|---|
| WER/%⬇ | SIM/%⬆ | CER/%⬇ | SIM/%⬆ | CER/%⬇ | SIM/%⬆ | |||
| MegaTTS3 | 0.5B | ❌ | 2.79 | 77.1 | 1.52 | 79.0 | - | - |
| DiTAR | 0.6B | ❌ | 1.69 | 73.5 | 1.02 | 75.3 | - | - |
| CosyVoice3 | 0.5B | ❌ | 2.02 | 71.8 | 1.16 | 78.0 | 6.08 | 75.8 |
| CosyVoice3 | 1.5B | ❌ | 2.22 | 72.0 | 1.12 | 78.1 | 5.83 | 75.8 |
| Seed-TTS | - | ❌ | 2.25 | 76.2 | 1.12 | 79.6 | 7.59 | 77.6 |
| MiniMax-Speech | - | ❌ | 1.65 | 69.2 | 0.83 | 78.3 | - | - |
| F5-TTS | 0.3B | ✅ | 2.00 | 67.0 | 1.53 | 76.0 | 8.67 | 71.3 |
| MaskGCT | 1B | ✅ | 2.62 | 71.7 | 2.27 | 77.4 | - | - |
| CosyVoice | 0.3B | ✅ | 4.29 | 60.9 | 3.63 | 72.3 | 11.75 | 70.9 |
| CosyVoice2 | 0.5B | ✅ | 3.09 | 65.9 | 1.38 | 75.7 | 6.83 | 72.4 |
| SparkTTS | 0.5B | ✅ | 3.14 | 57.3 | 1.54 | 66.0 | - | - |
| FireRedTTS | 0.5B | ✅ | 3.82 | 46.0 | 1.51 | 63.5 | 17.45 | 62.1 |
| FireRedTTS-2 | 1.5B | ✅ | 1.95 | 66.5 | 1.14 | 73.6 | - | - |
| Qwen2.5-Omni | 7B | ✅ | 2.72 | 63.2 | 1.70 | 75.2 | 7.97 | 74.7 |
| Qwen3-Omni | 30B-A3B | ✅ | 1.39 | - | 1.07 | - | - | - |
| OpenAudio-s1-mini | 0.5B | ✅ | 1.94 | 55.0 | 1.18 | 68.5 | 23.37 | 64.3 |
| IndexTTS2 | 1.5B | ✅ | 2.23 | 70.6 | 1.03 | 76.5 | 7.12 | 75.5 |
| VibeVoice | 1.5B | ✅ | 3.04 | 68.9 | 1.16 | 74.4 | - | - |
| HiggsAudio-v2 | 3B | ✅ | 2.44 | 67.7 | 1.50 | 74.0 | 55.07 | 65.6 |
| VoxCPM-0.5B | 0.6B | ✅ | 1.85 | 72.9 | 0.93 | 77.2 | 8.87 | 73.0 |
| VoxCPM1.5 | 0.8B | ✅ | 2.12 | 71.4 | 1.18 | 77.0 | 7.74 | 73.1 |
| MOSS-TTS | ✅ | 1.85 | 73.4 | 1.20 | 78.8 | - | - | |
| Qwen3-TTS | 1.7B | ✅ | 1.23 | 71.7 | 1.22 | 77.0 | 6.76 | 74.8 |
| FishAudio S2 | 4B | ✅ | 0.99 | - | 0.54 | - | 5.99 | - |
| LongCat-Audio-DiT | 3.5B | ✅ | 1.50 | 78.6 | 1.09 | 81.8 | 6.04 | 79.7 |
| VoxCPM2 | 2B | ✅ | 1.84 | 75.3 | 0.97 | 79.5 | 8.13 | 75.3 |
CV3-eval
CV3-eval 多语言 WER/CER(⬇) 结果 (点击展开)| 模型 | zh | en | hard-zh | hard-en | ja | ko | de | es | fr | it | ru |
|---|---|---|---|---|---|---|---|---|---|---|---|
| CosyVoice2 | 4.08 | 6.32 | 12.58 | 11.96 | 9.13 | 19.7 | - | - | - | - | - |
| CosyVoice3-1.5B | 3.91 | 4.99 | 9.77 | 10.55 | 7.57 | 5.69 | 6.43 | 4.47 | 11.8 | 10.5 | 6.64 |
| Fish Audio S2 | 2.65 | 2.43 | 9.10 | 4.40 | 3.96 | 2.76 | 2.22 | 2.00 | 6.26 | 2.04 | 2.78 |
| VoxCPM2 | 3.65 | 5.00 | 8.55 | 8.48 | 5.96 | 5.69 | 4.77 | 3.80 | 9.85 | 4.25 | 5.21 |
MiniMax-Multilingual-Test
Minimax-MLS-test WER(⬇) 结果 (点击展开)| 语言 | Minimax | ElevenLabs | Qwen3-TTS | FishAudio S2 | VoxCPM2 |
|---|---|---|---|---|---|
| Arabic | 1.665 | 1.666 | – | 3.500 | 13.046 |
| Cantonese | 34.111 | 51.513 | – | 30.670 | 38.584 |
| Chinese | 2.252 | 16.026 | 0.928 | 0.730 | 1.136 |
| Czech | 3.875 | 2.108 | – | 2.840 | 24.132 |
| Dutch | 1.143 | 0.803 | – | 0.990 | 0.913 |
| English | 2.164 | 2.339 | 0.934 | 1.620 | 2.289 |
| Finnish | 4.666 | 2.964 | – | 3.330 | 2.632 |
| French | 4.099 | 5.216 | 2.858 | 3.050 | 4.534 |
| German | 1.906 | 0.572 | 1.235 | 0.550 | 0.679 |
| Greek | 2.016 | 0.991 | – | 5.740 | 2.844 |
| Hindi | 6.962 | 5.827 | – | 14.640 | 19.699 |
| Indonesian | 1.237 | 1.059 | – | 1.460 | 1.084 |
| Italian | 1.543 | 1.743 | 0.948 | 1.270 | 1.563 |
| Japanese | 3.519 | 10.646 | 3.823 | 2.760 | 4.628 |
| Korean | 1.747 | 1.865 | 1.755 | 1.180 | 1.962 |
| Polish | 1.415 | 0.766 | – | 1.260 | 1.141 |
| Portuguese | 1.877 | 1.331 | 1.526 | 1.140 | 1.938 |
| Romanian | 2.878 | 1.347 | – | 10.740 | 21.577 |
| Russian | 4.281 | 3.878 | 3.212 | 2.400 | 3.634 |
| Spanish | 1.029 | 1.084 | 1.126 | 0.910 | 1.438 |
| Thai | 2.701 | 73.936 | – | 4.230 | 2.961 |
| Turkish | 1.52 | 0.699 | – | 0.870 | 0.817 |
| Ukrainian | 1.082 | 0.997 | – | 2.300 | 6.316 |
| Vietnamese | 0.88 | 73.415 | – | 7.410 | 3.307 |
| 语言 | Minimax | ElevenLabs | Qwen3-TTS | FishAudio S2 | VoxCPM2 |
|---|---|---|---|---|---|
| Arabic | 73.6 | 70.6 | – | 75.0 | 79.1 |
| Cantonese | 77.8 | 67.0 | – | 80.5 | 83.5 |
| Chinese | 78.0 | 67.7 | 79.9 | 81.6 | 82.5 |
| Czech | 79.6 | 68.5 | – | 79.8 | 78.3 |
| Dutch | 73.8 | 68.0 | – | 73.0 | 80.8 |
| English | 75.6 | 61.3 | 77.5 | 79.7 | 85.4 |
| Finnish | 83.5 | 75.9 | – | 81.9 | 89.0 |
| French | 62.8 | 53.5 | 62.8 | 69.8 | 73.5 |
| German | 73.3 | 61.4 | 77.5 | 76.7 | 80.3 |
| Greek | 82.6 | 73.3 | – | 79.5 | 86.0 |
| Hindi | 81.8 | 73.0 | – | 82.1 | 85.6 |
| Indonesian | 72.9 | 66.0 | – | 76.3 | 80.0 |
| Italian | 69.9 | 57.9 | 81.7 | 74.7 | 78.0 |
| Japanese | 77.6 | 73.8 | 78.8 | 79.6 | 82.8 |
| Korean | 77.6 | 70.0 | 79.9 | 81.7 | 83.3 |
| Polish | 80.2 | 72.9 | – | 81.9 | 88.4 |
| Portuguese | 80.5 | 71.1 | 81.7 | 78.1 | 83.7 |
| Romanian | 80.9 | 69.9 | – | 73.3 | 79.7 |
| Russian | 76.1 | 67.6 | 79.2 | 79.0 | 81.1 |
| Spanish | 76.2 | 61.5 | 81.4 | 77.6 | 83.1 |