Sana

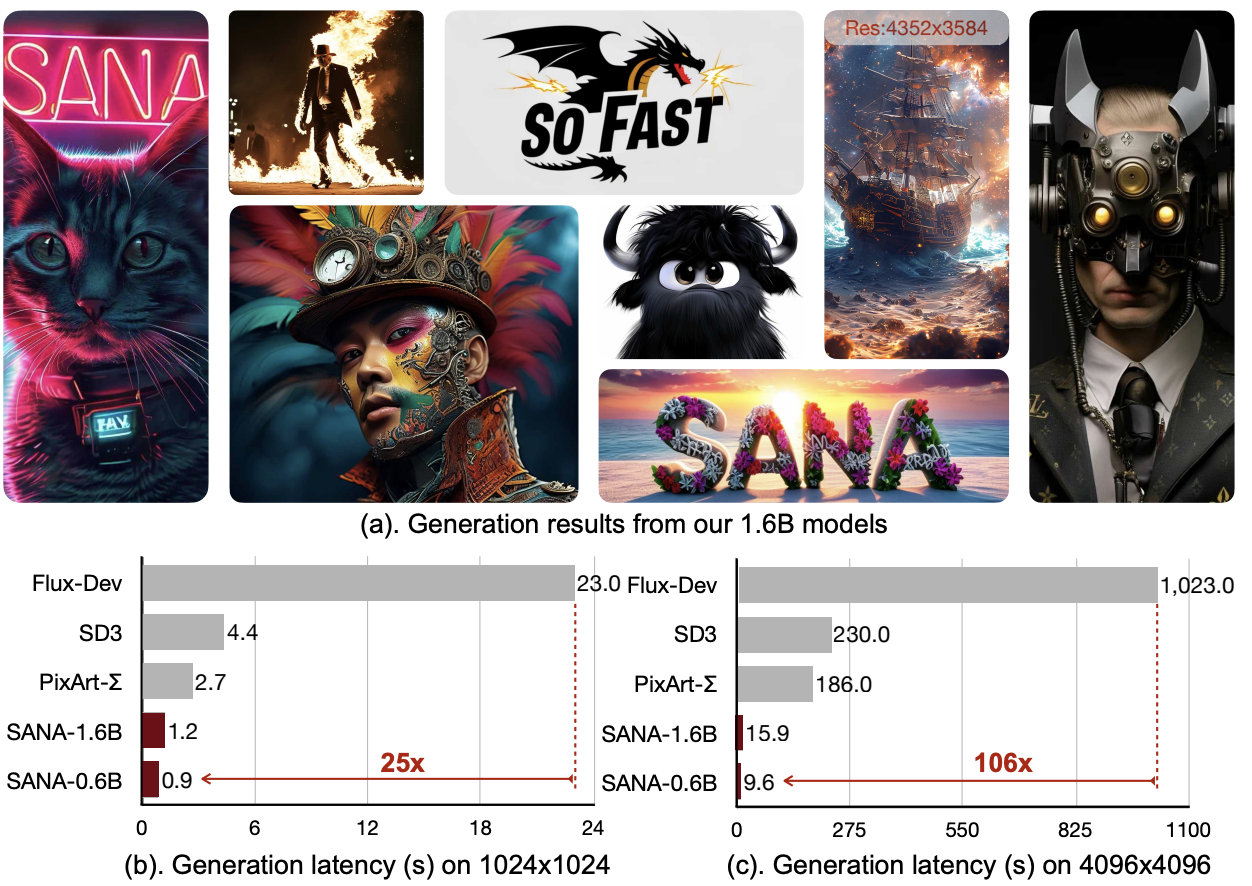
基于线性 Diffusion Transformer 的高效图像/视频生成框架,支持从 512px 到 4K 分辨率的 T2I 和 T2V。核心亮点是采用 Linear Attention + DC-AE 32× 压缩大幅降低计算量,在 1024×1024 生成上比 FLUX 快 20 倍以上,且模型仅 1.6B 参数。已发布 SANA-1.5(训练/推理缩放)、SANA-Sprint(一步生成)、SANA-Video(长视频)等系列,支持 ComfyUI、Diffusers、SGLang 部署。研究向,开源 Apache 2.0。
README
📚 文档 | SANA | SANA-1.5 | SANA-Sprint | SANA-Video | SANA-WM | Sol-RL
Demo | 🤗 HuggingFace | ComfyUI | SGLang | Cosmos-RL
ICLR 2025 Oral | ICML 2025 | ICCV 2025 Highlight | ICLR 2026 Oral
SANA 是一个以效率为核心的高分辨率图像和视频生成代码库,提供完整的训练和推理流程。本仓库包含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM 和 Sol-RL 的代码。更多细节请查看我们的 📚 文档。
加入我们的 Discord 社区参与讨论!如有任何问题、遇到 Bug 或想贡献代码,欢迎随时联系我们!
新闻
- 🔥 [2026/05] 🌍 SANA-WM: 2.6B 可控世界模型 发布!支持 720p、1 分钟视频生成,6自由度相机控制。世界模型和具身AI的新基线。参见 项目页 | 论文.
- 🔥 [2026/04] ⚡ Sol-RL: NVFP4 展开、BF16 训练 RL 可用!包括 SANA、FLUX.1 和 SD3.5-L 的所有训练配方,以及捆绑的后训练数据集。参见 Sol-RL 文档 | 页面 | 论文.
- 🔥 [2026/03] 📺 SANA-Video 720p 模型(含 LTX-VAE) 发布。配合 LTX2 Refiner 可将视频上采样至 2K 分辨率!参见 模型动物园、SANA-Video 文档 和 关于 Refiner 的博客.
- 🔥 [2026/03] 💪 后训练基础设施:SANA × Cosmos-RL — 我们与 Cosmos-RL 合作,为 SANA 提供完整的 RL 基础设施。您现在可以使用最先进的算法(如 Diffusion-NFT、Flow-GRPO)、预设配置、奖励服务和灵活的数据集对 SANA-Image 和 SANA-Video 进行后训练(SFT/RL)。参见 Cosmos-RL 上的 SANA 和我们的 Cosmos-RL 集成文档.
- 🔥 [2026/02] 🚀 SANA 现已支持 SGLang! 高性能服务,兼容 OpenAI API。[使用指南]
- 🔥 [2026/01/26] SANA-Video 被 ICLR-2026 接收为 Oral。 🎉🎉🎉
- 🔥 [2025/12/09] 🎬 LongSANA: 27FPS 实时分钟级视频生成模型,训练和推理代码均已发布。感谢 LongLive Team。参考:[Train] | [Test] | [Weight]
- 🔥 [2025/11/24] 🪶 博客: Causal Linear Attention 如何为 LLM 和长视频生成解锁无限上下文。
- 🔥 [2025/11/9] 🎬 介绍视频 展示了 Block Causal Linear Attention 和 Causal Mix-FFN 的工作原理。
- 🔥 [2025/11/6] 📺SANA-Video 已合入 diffusers。如何使用.
- 🔥 [2025/10/27] 📺SANA-Video 发布。[README] | [权重] 支持文本到视频、文本图像到视频。
- 🔥 [2025/10/13] 📺SANA-Video 即将发布,1). 5秒 Linear DiT 视频模型,2). 实时分钟级视频生成(配合 LongLive)。[论文] | [页面]
- ✅ [2025/8/20] 发布新版 DC-AE-Lite,推理更快、内存更小。[配置方法] | [diffusers PR] | [权重]
- ✅ [2025/6/25] SANA-Sprint 被 ICCV'25 接收 🏖️
- ✅ [2025/6/4] SANA-Sprint ComfyUI 节点 发布 [示例].
- ✅ [2025/5/8] SANA-Sprint(一步扩散)diffusers 训练代码发布 [指南].
- ✅ [2025/5/4] SANA-1.5(推理时间缩放)被 ICML-2025 接收。 🎉🎉🎉
- ✅ [2025/3/22] 🔥SANA-Sprint demo 已在 HuggingFace 上托管,快来体验! 🎉 [Demo 链接]
- ✅ [2025/3/22] 🔥SANA-1.5 现已支持 ComfyUI! 🎉: ComfyUI 指南 | ComfyUI 工作流 SANA-1.5 4.8B
- ✅ [2025/3/22] 🔥SANA-Sprint 代码 & 权重发布! 🎉 包括:训练 & 推理 代码和 权重 / HF 均已发布。[指南]
- ✅ [2025/3/21] 🚀Sana + 推理缩放 发布。[指南]
- ✅ [2025/3/16] 🔥SANA-1.5 代码 & 权重发布! 🎉 包括:DDP/FSDP | TAR 文件 WebDataset | 多尺度 训练代码和 权重 | HF 均已发布。
- ✅ [2025/3/14] 🏃SANA-Sprint 即将发布! 🎉 SANA 的新一代单/少步生成器。H100 上 0.1 秒生成 1024px 图像,RTX 4090 上 0.3 秒。了解更多详情:[页面] | [Arxiv]。代码很快将与
diffusers一起发布。 - ✅ [2025/2/10] 🚀Sana + ControlNet 发布。[指南] | [模型] | [Demo]
- ✅ [2025/1/30] 发布 CAME-8bit 优化器代码。训练时节省更多 GPU 内存。[配置方法]
- ✅ [2025/1/29] 🎉 🎉 🎉SANA 1.5 发布!探索高效的训练和推理缩放! 🚀[技术报告]
- ✅ [2025/1/24] 4bit-Sana 发布,基于 SVDQuant 和 Nunchaku 推理引擎。现在可在 8GB GPU 显存内运行 Sana [指南] [Demo] [模型]
- ✅ [2025/1/24] DCAE-1.1 发布,重建质量更优。[模型] [diffusers]
- ✅ [2025/1/23] Sana 被 ICLR-2025 接收为 Oral。 🎉🎉🎉
- ✅ [2025/1/12] DC-AE tiling 使得 Sana-4K 推理 4096x4096px 图像仅需 22GB GPU 内存。配合模型卸载和 8bit/4bit 量化,4K Sana 可在 8GB GPU 显存内运行。[指南]
- ✅ [2025/1/11] Sana 代码库许可证变更为 Apache 2.0。
- ✅ [2025/1/10] 使用 8bit 量化推理 Sana。[指南]
- ✅ [2025/1/8] 4K 分辨率 Sana 模型 在 Sana-ComfyUI 中提供支持,并准备了工作流。[4K 指南]
- ✅ [2025/1/8] 1.6B 4K 分辨率 Sana 模型 发布:[BF16 pth] 或 [BF16 diffusers]。🚀 20 秒内获得 4096x4096 分辨率图像!在 Sana 页面 查看更多样本。感谢 SUPIR 的出色工作和支持。
- ✅ [2025/1/2]
diffuserspipeline 中的 Bug 已修复。已解决的 PR - ✅ [2025/1/2] 2K 分辨率 Sana 模型 在 Sana-ComfyUI 中提供支持,并准备了工作流。
- ✅ [2024/12] 1.6B 2K 分辨率 Sana 模型 发布:[BF16 pth] 或 [BF16 diffusers]。🚀 4 秒内获得 2K 分辨率图像!在 Sana 页面 查看更多样本。感谢 SUPIR 的出色工作和支持。
- ✅ [2024/12]
diffusers支持 Sana-LoRA 微调!Sana-LoRA 的训练和收敛速度极快。[指南] 或 [diffusers 文档]. - ✅ [2024/12]
diffusers现已包含 Sana!所有 diffusers safetensors 格式的 Sana 模型 已发布,diffusers pipelineSanaPipeline、SanaPAGPipeline、DPMSolverMultistepScheduler(with FlowMatching)现已全部支持。我们准备了一个模型卡片供您选择。 - ✅ [2024/12] 1.6B BF16 Sana 模型 发布,用于稳定微调。
- ✅ [2024/12] 我们发布了 Sana 的 ComfyUI 节点。[指南]
- ✅ [2024/11] 所有多语言(Emoji & 中文 & 英文)SFT 模型已发布:1.6B-512px、1.6B-1024px、600M-512px、600M-1024px。指标表现见此处
- ✅ [2024/11] Sana Replicate API 在 Sana-API 上线。
- ✅ [2024/11] 1.6B Sana 模型 发布。
- ✅ [2024/11] 训练 & 推理 & 指标代码发布。
- ✅ [2024/11] 正在推进
diffusers. - [2024/10] Demo 发布。
- [2024/10] DC-AE 代码 和 权重 发布!
- [2024/10] 论文 已在 Arxiv 上线。
💡 简介
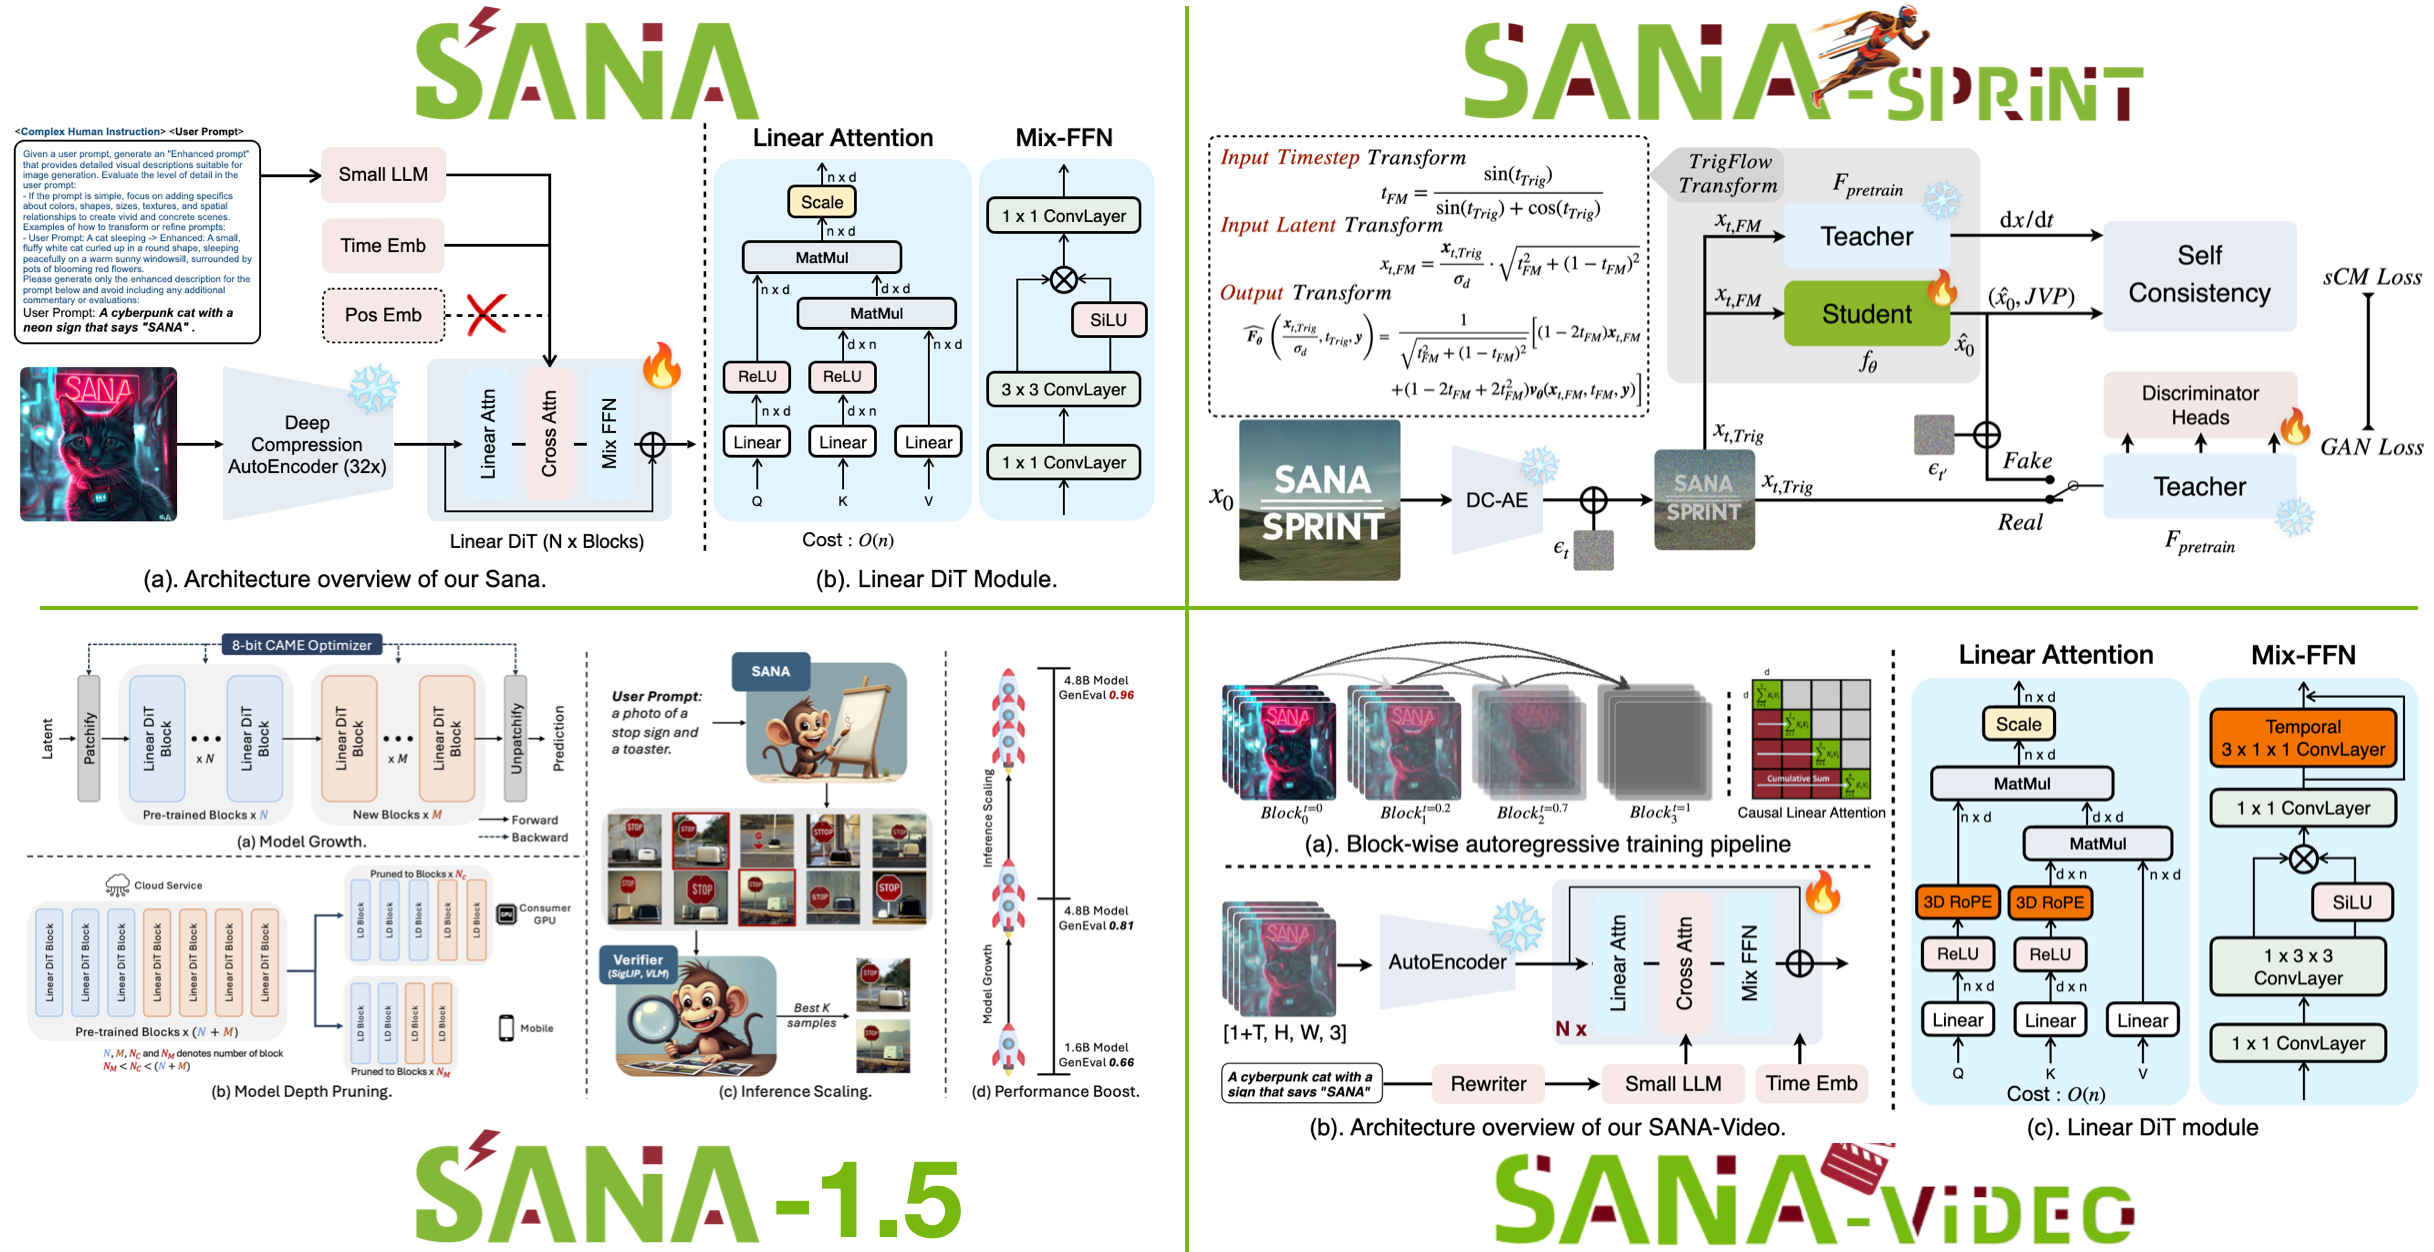
我们推出 SANA,一系列高效扩散模型,用于高分辨率图像和视频生成:
- SANA:最高 4K 分辨率的文本到图像生成,体积比 Flux-12B 小 20 倍,速度快 100 倍。
- SANA-1.5:高效的训练时间和推理时间计算缩放,以获得更高质量。
- SANA-Sprint:通过 sCM 蒸馏实现单步/少步生成,H100 上 0.1 秒生成 1024px 图像。
- SANA-Video/LongSANA:高效的视频生成,采用 Block Linear Attention / LongLive。
- Sol-RL:NVFP4 展开、BF16 训练 RL,实现 4.64× 更快收敛。
- SANA-WM:2.6B 参数可控世界模型,生成 720p、1 分钟视频世界,支持 6-DoF 相机控制。
关键技术:
- Linear Attention:用线性注意力替换 DiT 中的标准注意力,在高分辨率下提高效率。
- DC-AE:32× 图像压缩(相比传统 8×),减少 latent 令牌数。
- Decoder-only Text Encoder:现代 decoder-only LLM,结合 in-context learning,实现更好的文本-图像对齐。
- Block Causal Linear Attention & Causal Mix-FFN:高效的注意力和前馈网络,用于长视频生成。
- Flow-DPM-Solver:通过高效的训练和采样减少采样步数。
- sCM Distillation:通过连续时间一致性蒸馏实现单步/少步生成。
- Sol-RL:低精度(NVFP4)展开选择,高精度(BF16)优化,加速 RL 训练。
- 可控世界建模:高效长上下文建模和相机轨迹控制,实现一致的 world generation。
总结,SANA 是一个完全开源的框架,集成了高效的训练、快速推理和灵活部署,适用于图像和视频生成。通过 4-bit 量化,可在显存 < 8GB 的笔记本 GPU 上部署。
快速开始
git clone https://github.com/NVlabs/Sana.git
cd Sana && ./environment_setup.sh sana
使用 🧨 diffusers 推理
import torch
from diffusers import SanaPipeline

pipe = SanaPipeline.from_pretrained(
    "Efficient-Large-Model/SANA1.5_1.6B_1024px_diffusers",
    torch_dtype=torch.bfloat16,
)
pipe.to("cuda")

pipe.vae.to(torch.bfloat16)
pipe.text_encoder.to(torch.bfloat16)

prompt = 'a cyberpunk cat with a neon sign that says "Sana"'
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=4.5,
    num_inference_steps=20,
    generator=torch.Generator(device="cuda").manual_seed(42),
)[0]

image[0].save("sana.png")
[!TIP] 升级您的
diffusers>=0.32.0以使用SanaPipeline。更多细节见 📚 文档.
入门指南
- 📚 完整文档
- 安装指南
- 模型动物园
- Sana 推理与训练
- SANA-Sprint
- SANA-Video
- LongSANA
- SANA-WM(即将推出)
- ControlNet
- LoRA / DreamBooth
- Sol-RL 后训练
- 量化(4bit / 8bit)
- ComfyUI
- SGLang
性能
图像生成(1024px)
| 方法 (1024x1024) | 吞吐量 (samples/s) | 延迟 (s) | 参数量 (B) | 加速比 | FID ↓ | CLIP ↑ | GenEval ↑ | DPG ↑ |
|---|---|---|---|---|---|---|---|---|
| FLUX-dev | 0.04 | 23.0 | 12.0 | 1.0× | 10.15 | 27.47 | 0.67 | 84.0 |
| Sana-0.6B | 1.7 | 0.9 | 0.6 | 39.5× | 5.81 | 28.36 | 0.64 | 83.6 |
| Sana-0.6B | 1.7 | 0.9 | 0.6 | 39.5× | 5.61 | 28.80 | 0.68 | 84.2 |
| Sana-1.6B | 1.0 | 1.2 | 1.6 | 23.3× | 5.92 | 28.94 | 0.69 | 84.5 |
| Sana-1.5 1.6B | 1.0 | 1.2 | 1.6 | 23.3× | 5.70 | 29.12 | 0.82 | 84.5 |
| Sana-1.5 4.8B | 0.26 | 4.2 | 4.8 | 6.5× | 5.99 | 29.23 | 0.81 | 84.7 |
视频生成(VBench 720p)
| 模型 | 延迟 (s) | 参数量 (B) | VBench 总分 ↑ | 质量分 ↑ | 语义分 ↑ |
|---|---|---|---|---|---|
| Wan-2.1-14B | 1897 | 14 | 83.73 | 85.77 | 75.58 |
| Wan-2.1-1.3B | 400 | 1.3 | 83.38 | 85.67 | 74.22 |
| SANA-Video-2B | 36 | 2 | 84.05 | 84.63 | 81.73 |
💪待办列表
我们将尽力实现以下目标
- [✅] 训练代码
- [✅] 推理代码
- [✅] 模型动物园
- [✅] ComfyUI 节点(SANA, SANA-1.5, SANA-Sprint)
- [✅] DC-AE Diffusers
- [✅] Sana 合入 Diffusers (https://github.com/huggingface/diffusers/pull/9982)
- [✅] LoRA 训练 @paul (
diffusers: https://github.com/ huggingface/diffusers/pull/10234) - [✅] 2K/4K 分辨率模型。(感谢 @SUPIR 提供 4K 超分辨率模型)
- [✅] 8bit / 4bit 笔记本开发
- [✅] ControlNet(训练 & 推理 & 模型)
- [✅] FSDP 训练
- [✅] SANA-1.5(更大模型尺寸 / 推理缩放)
- [✅] SANA-Sprint:少步生成器
- [✅] 更快的 DCAE-Lite 权重
- [✅] 更好的重建 F32/F64 VAEs
- [✅] SANA-Video:Linear DiT 视频模型,以及实时分钟级