Soup
从单一 YAML 配置微调 LLM 的 CLI 工具,免去 SSH 和繁杂环境配置,一条命令完成训练、评估、导出。核心亮点是 layer streaming 技术,把冻结的 base model 按 decoder 层逐个流式送入 GPU,让 8B 模型在 4GB 显存笔记本上以 QLoRA 微调,实测 119.6 tok/s、峰值 3.32GB,并且与常驻显存运行的结果 bit-exact。附带 DPO/ORPO 等偏好对齐、reward synth、ship 发布门禁等完整工作流,开源且测量数据透明。
README
Soup
一条命令微调(fine-tune)和继续训练 LLM。无需 SSH,无需折腾配置。
官网 · 快速开始 · 配置 · 文档 · 命令 · 模型 · Discord · Product Hunt




Soup 把 LLM 微调的痛苦变成一条简单的工作流。一个配置文件,一条命令,完事。
pip install "soup-cli[train]"   # 加 [train] 可微调;裸的 `soup-cli` 是轻量 CLI
soup init --template chat
soup train
**在 4 GB 笔记本 GPU 上微调 8B 模型。**Layer streaming 把冻结的主干模型(frozen base)移出
VRAM,逐个 decoder 层送入 GPU。在 RTX 3050 Laptop 4 GB 上实测:
Llama-3.1-8B-Instruct + NF4 达到 119.6 tok/s,峰值 3.32 GB —— 与常驻运行的逐位(bit-exact)结果一致,
并在 H100 上独立复现为 113.00 tok/s,同样占用 3.32 GB。
(该 tok/s 数值是在 v0.72.2 上测得的,早于 v0.73.0 正确性修复;该修复在 32B 上损失
−4.8%;此后再未在 4 GB 卡上重测。)默认关闭(stream_layers: true 启用),仍属 BETA —
原理 ·
全部实测数据 · 论文 ·
在免费 Colab T4 上自行验证(把进程限制到
4 GB,然后断言流式模型与普通模型逐位一致)
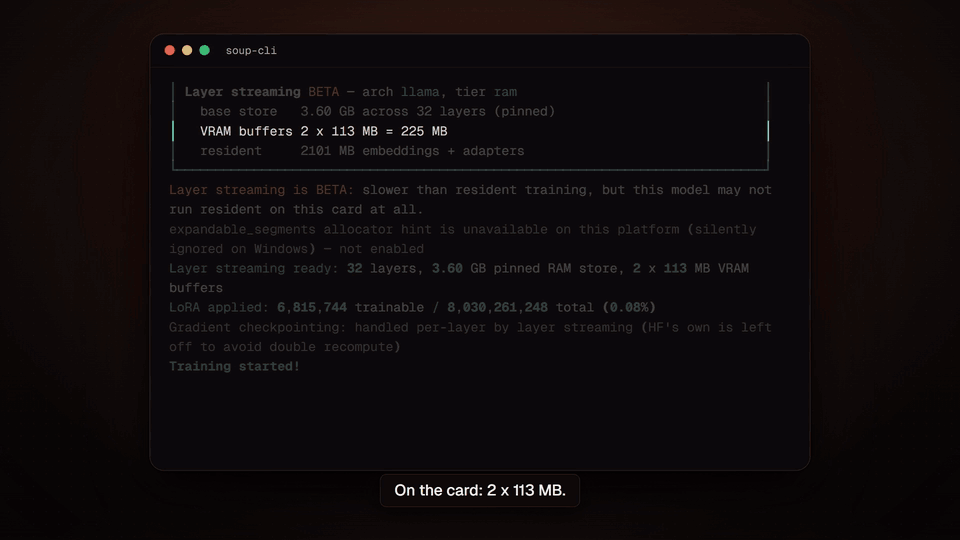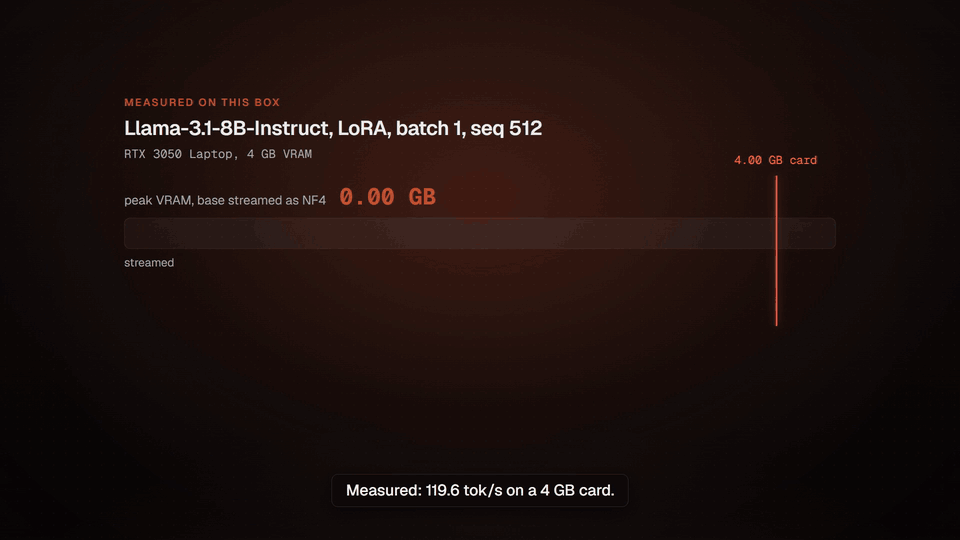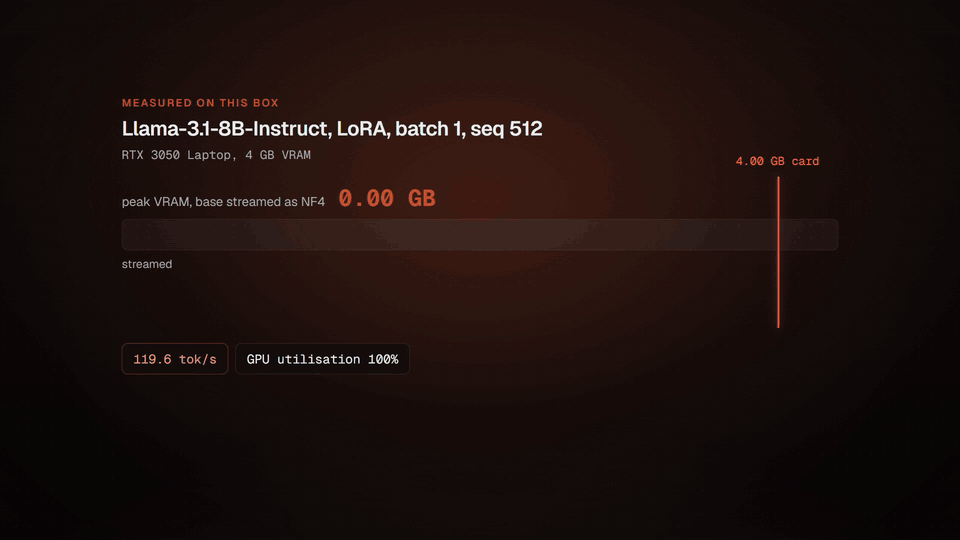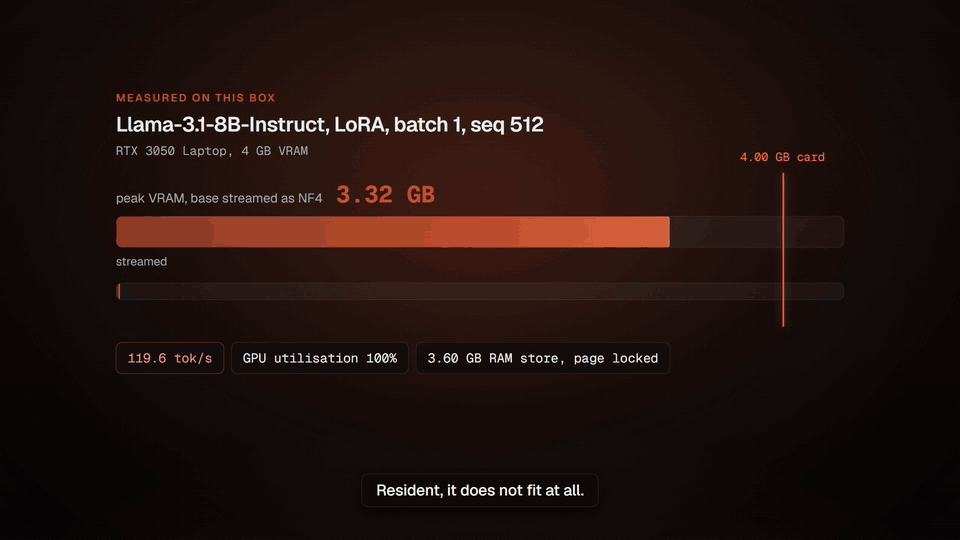
Llama-3.1-8B-Instruct + NF4,LoRA,batch 1,seq 512,RTX 3050 Laptop 4 GB —— 峰值 3.32 GB,119.6 tok/s。 完整视频(90 秒)
为什么选择 Soup?
训练 LLM 仍然很痛苦。即使是有经验的团队,也会花 30-50% 的时间去搞定基础设施,而不是改进模型。Soup 解决了这个问题。
- 零 SSH。 再也不需要 SSH 到一台坏掉的 GPU 机器上。
- 一个配置文件。 一个简单的 YAML 文件就足够了。
- 全自动。 批量大小、GPU 检测、量化 —— 全都处理好了。
- 本地运行。 使用 QLoRA 在自己的 GPU 上训练,无需云环境。
更新动态
v0.73.2 —— 发布门禁(release gate)不再两头撒谎。 soup ship 只回答一个问题:
这个模型是变好了,还是被我改坏了?其中两套评测套件一直在用错误的标准排序,而且整个“失败方向”压根没有检测器。
- 一个套件给一个 40/40 全对的模型打了 0.225。
mini_tool_call在给括号整洁度打分: 模型少输出了一个右括号,于是解析回退到内部对象,评分器因缺少外层键而拒绝。而mini_mmlu给 Llama-3.1-8B 打了 0.423——比 0.5B 模型还低——因为提取器不认识\boxed{C},而提示词从未要求输出字母。两者都已修复;0.423 → 0.731。 - 新增:良性提示(benign-prompt)维度。 Leg 2 只能捕获拒绝率的下降,没有反向检测,
于是一个拒绝所有请求的模型会被看成单调的“安全改进”。两个模型在全部七套内置套件上得分逐位一致,
其中一个是拒绝所有良性请求的模型,但门禁无法区分它们。
mini_over_refusal是它的镜像; 与安全套件配对后,无法单独钻某一个的空子。 - 新增:
soup ship --noise-floor N重复运行基线模型 N 次,并拒绝把任何小于实测波动范围的差值 判定为显著。贪婪解码(greedy decoding)在 GPU 上并非确定性——同一模型、无 adapter,五次运行的 波动范围达到 0.015–0.020(阈值 0.05),而该会话中六对配对差值里有四对落在噪声底之内。 它量化效应大小,而不是标定阈值;发布说明中也明确写出了这一点。 - 一个调用方错误被误判为回归。 一个不可调用的生成器在三个套件上得了
0.0,在其他套件上直接报错—— 而在 leg 2 中,0.0 会被解读为“每项都失败”,也就是说,它的失败方向恰好看起来像是一个发现。 - 另外:
soup data split --stratify-semantic(#388)和soup mcp serve --allow-execute(#391),均来自外部贡献者。
上一个版本中 VRAM 相关工作的实测记录——按原始形态发布,包括期间撤回的三次读数——
见 benchmarks/gate-v0.73.1-measured-vram-fit.md。
# soup.yaml — 然后只需执行 `soup train --config soup.yaml`
training:
  stream_layers: true      # 主干模型从 VRAM 流式读出;只训练 adapter
  quantization: 4bit       # NF4 — 存储缩小约 4 倍,因此 8B 可放进 4 GB 卡
  batch_size: 4            # 更大的 batch 摊薄权重读取开销
  stream_source: auto      # 能放进 RAM 就用 RAM,放不下就用 NVMe 磁盘
  seed: 1234               # v0.73.0 新增
上一个版本 — v0.72.4,在笔记本上对齐(DPO / ORPO / SimPO / KTO 叠加 layer streaming)仅支持 Python 3.10–3.12。v0.73.0 补上了此前缺失的上限:在 3.13+ 上,pip 以前会解析到未经验证的 PyTorch wheel,这些 wheel 在 Soup 运行前就会在原生扩展中崩溃。
Layer streaming 之前只支持监督微调(SFT);v0.72.4 将其扩展到偏好损失。风险只有一个:DPO 需要参考模型,
如果再 copy 一份,内存翻倍,就失去了意义。Soup 的做法是使用同一个流式主干,但关闭其 adapter——
实测为 SFT 峰值的 0.914×,而强行再实例化一份则要多占 +730 MB,正好是一份权重的体积。
四种方法都与普通非流式运行逐位一致。诚实的代价:内存上免费,时间上不免费——DPO 每一步读取
层栈的频率是原来的 1.52×。grpo / ppo 仍然有意排除在外。
上一个版本 — v0.71.40,soup reward synth(从你的数据生成奖励验证器)在 v0.72.0 上使用
stream_layers: true训练过? 那个 adapter 是无效的——它的张量被保存 在带有额外.inner.段的键下,所以所有加载器都会返回未微调的主干模型。 已在 v0.72.1 修复;请重新运行或重新保存。检查方法:python -c "from safetensors.torch import load_file; print([k for k in load_file('adapter_model.safetensors') if '.inner.' in k][:3])"
把 soup reward synth 指向一个参考输出的 JSONL,它会推断出一个确定性验证器,
生成可读、可提交的 .py 奖励函数,并且——这是别人做不到的部分——拒绝
生成一个无法区分你的参考答案和错误答案的验证器(四种类型:numeric / json_schema /
regex / tool_call;强制校准报告是护城河)。奖励集成
(reward_fn: "accuracy,format")现在也可以训练了。(#311)
soup reward synth references.jsonl -o reward.py --output-report calib.json
soup ship 的判定现在可以导出、提交并绑定来源:--emit-evidence 可以让一次运行
重放得到完全相同的判定;soup.yaml 中的 eval.ship + --config 让门禁策略可审查;
--config 将证据绑定到产生它的确切配方上(证据过期 → 退出码 3)。
soup ship --push owner/repo#N 会把 SHIP / DON'T-SHIP 卡片发布到 PR 上。
soup ship 的回归测试真正落地了:一个基于提取的固定评分器,覆盖七套内置离线套件
(MCQ · 算术 · 工具调用 · JSON 合法性 · 安全/拒绝)。一个在你的任务上赢了、但悄悄破坏工具调用的
模型,现在会得到 DON'T SHIP。零新增依赖。
soup ship --base ./base --adapter ./my-lora --task-eval my_task.jsonl
#   exit 0 = SHIP · 2 = DON'T SHIP · 3 = 参数错误 · 1 = 运行时错误
完整历史:CHANGELOG.md · GitHub Releases。
快速开始
1. 安装
# 轻量核心:CLI + 配置 + 数据处理工具,无 PyTorch
pip install soup-cli

# 添加训练栈(torch, transformers, peft, trl, datasets, …)
pip install "soup-cli[train]"

# 一次装齐(train + serve + ui + data)
pip install "soup-cli[all]"

# 或从 GitHub 安装(最新开发版)
pip install git+https://github.com/MakazhanAlpamys/Soup.git
完整 extras 表(fast、mlx、serve、eval、ui、vision、audio、…)见
docs/models.md。
用双引号,不要用单引号。
"soup-cli[train]"是唯一在所有 shell 里都能用的写法——cmd.exe、PowerShell、bash 和 zsh 都是。如果你从旧教程复制了'soup-cli[train]'且 pip 拒绝执行,原因就在这里: 为什么,以及确切的报错。
soup init、soup data … 以及其他数据/检查命令在轻量安装下即可使用。
微调(soup train)需要 [train] extra。
2. 创建配置
soup init                       # 交互式向导
soup init --template chat       # 或从模板开始
模板:chat、code、tool-calling、medical、reasoning、vision、kto、orpo、
simpo、ipo、bco、rlhf、pretrain、moe、longcontext、embedding、audio。
3. 训练、测试、发布
soup train --config soup.yaml                 # LoRA、量化、批处理——全部自动搞定
soup chat  --model ./output                    # 和你的模型对话
soup push  --model ./output --repo you/my-model

soup merge  --adapter ./output                              # 将 LoRA 合并进主干模型
soup export --model ./output --format gguf --quant q4_k_m   # 导出 GGUF 供 Ollama / llama.cpp 使用
更多导出目标(ONNX、TensorRT、AWQ、GPTQ、BitNet)和部署选项见
docs/serving-and-export.md。
配置
一个完整的 soup.yaml:
base: meta-llama/Llama-3.1-8B-Instruct
task: sft
# backend: unsloth  # 快 2-5 倍,pip install "soup-cli[fast]"

data:
  train: ./data/train.jsonl
  format: alpaca
  val_split: 0.1

training:
  epochs: 3
  lr: 2e-5
  batch_size: auto
  lora:
    r: 64
    alpha: 16
  quantization: 4bit

output: ./output
config/schema.py 是每个字段的唯一事实来源。高级数据、训练和 PEFT 选项见 文档。
文档
完整功能参考在 docs/ 目录。从这里开始:
| 指南 | 覆盖内容 |
|---|---|
| 训练任务与方法 | SFT、DPO/GRPO/PPO/KTO/ORPO/SimPO/IPO/BCO、工具调用、PRM、预训练、蒸馏、分类、视觉/音频/TTS、去学习(unlearning)、RAFT/RA-DIT、循环加固检测器 |
| PEFT、长上下文与效率 | DoRA、LoRA+、rsLoRA、VeRA、OLoRA、NEFTune、PiSSA、ReLoRA、优化器与 PEFT 全家桶、LLaMA Pro、GaLore、YaRN/LongLoRA、packing、课程学习、自动调参 |
| 性能与量化 | QAT、FP8、量化菜单(I + II)、KV-cache、NVFP4、保存格式、Cut Cross-Entropy、梯度检查点、kernel、激活卸载、layer streaming、多 GPU / DeepSpeed / FSDP |
| 数据工程 | 格式、Axolotl/LF 对齐管线、数据工具、合成生成与锻造(forge)、质量记分卡、追踪工具、远程数据集、混合、配方 DAG |
| 评估与探针 | 评估设计与门禁、评估门控训练、基准测试、NLG 指标、校准、Elo 竞技场、诊断、后训练 X-ray 探针、A/B、漂移、可调性、soup advise |
| 服务与导出 | OpenAI 兼容服务器、批量推理、基准测试、合并/导出、Anthropic Messages 端点、投机解码(训练并测量你自己的 draft)、部署自动驾驶、Web UI、Agent Forge |
| Adapter、注册表与治理 | Adapter 生命周期/管理、模型注册表、Soup Cans、数据飞轮(soup loop)、知识编辑、引导(steering)、供应链控制(scan/sign/BOM/attest/audit/airgap) |
| 合规与治理快速入门 | HIPAA/SOC2/EU-AI-Act/SR-11-7 init 模板、来源(BOM/attest/repro-receipt)、审计日志、离线隔离(air-gap)、模型卡自动生成(soup card)、CI 门禁(soup ci init) |
| 后端、平台与运维 | MLX/Unsloth 后端、替代 hub、HF Hub 集成、自动驾驶、实验追踪、plan/apply、环境 lockfile、硬件事配、completions、插件、实用命令 |
| 命令参考 | 完整的 soup 命令列表 |
| 支持的模型与 extras | 推荐模型系列、VRAM 容量指南、pip extras 矩阵 |
数据格式
Alpaca、ShareGPT、ChatML、偏好对(DPO / ORPO / SimPO / IPO / KTO)、视觉、音频、
ASR、纯文本、embedding、RAFT 等——全部可以从 JSONL、JSON、CSV、Parquet 或
TXT 自动检测,所以在大多数情况下,你只需把 data.train 指向一个文件,其他都不用改。每种格式
都配有示例的 schema,以及数据管线(远程 URI、流式、分片、交错、词汇扩展、文档摄取),见
docs/data.md。
常用命令
soup train  --config soup.yaml        # 训练(SFT/DPO/GRPO/PPO/KTO/ORPO/SimPO/IPO/...)
soup infer  --model ./output --input prompts.jsonl   # 批量推理
soup chat   --model ./output          # 交互式对话
soup serve  --model ./output          # OpenAI 兼容 API 服务器
soup merge  --adapter ./output        # 将 LoRA 合并进主干模型
soup export --model ./output --format gguf           # 导出用于部署
soup eval   benchmark --model ./output               # 评估
soup data   inspect ./data/train.jsonl               # 数据集统计
soup recipes list                     # 100+ 现成模型配方
soup autopilot --model <id> --data d.jsonl --goal chat  # 零配置
soup doctor                           # 检查 GPU / 依赖 / 环境
完整命令列表见 docs/commands.md。
支持的模型
Soup 兼容 HuggingFace Hub 上的
任何文本生成模型——只要能通过 AutoModelForCausalLM 加载,就能工作,零配置改动。
Llama 3.x/4、Qwen 2.5/3、Gemma 3、Mistral、Mixtral、DeepSeek R1/V3、Phi-4,以及 100+ 其他模型
都有现成配方(soup recipes list)。
| VRAM | 最大模型(QLoRA 4-bit) | 示例 |
|---|---|---|
| 8 GB | ~7B | Llama-3.1-8B、Mistral-7B |
| 16 GB | ~14B | Phi-4-14B、Qwen2.5-14B |
| 24 GB | ~34B | CodeLlama-34B、Yi-1.5-34B |
| 48 GB | ~70B | Llama-3.3-70B |
| 80 GB+ | 70B+(全量)或 MoE | Mixtral-8x22B、DeepSeek-V3 |
完整模型 + 视觉表格和可选 extras 矩阵见 docs/models.md。
Docker
无需在本地安装 CUDA 或 PyTorch 即可运行 Soup(镜像在每次发布时发布到 GHCR):
docker pull ghcr.io/makazhanalpamys/soup:latest
docker run --gpus all -v $(pwd):/workspace ghcr.io/makazhanalpamys/soup train --config soup.yaml
docker compose up   # 或在本地构建
环境要求
- Python 3.10、3.11 或 3.12(CI 测试的就是这些版本;3.13+ 暂不支持, 因为 PyTorch 技术栈尚未在这些版本上验证)
- 带 CUDA 的 GPU(推荐)、Apple Silicon(MPS)或 CPU(实验性——非常慢)
- 7B 模型 + QLoRA 需要 8 GB 以上 VRAM
所有训练任务都可在 CPU 上运行以进行测试(量化会自动禁用)。可选 extras
(train、all、fast、vision、qat、serve、serve-fast、ui、eval、deepspeed、
liger、mlx、onnx、tensorrt、…)列在
docs/models.md。
故障排查
soup doctor # 在一个地方查看 GPU、系统资源、依赖和版本
ImportError: DLL load failed while importing _C(Windows) —— 重新安装与你 CUDA 版本匹配的 PyTorch:pip install torch --index-url https://download.pytorch.org/whl/cu121。soup version≠pip show soup-cli—— 安装了多个 Python;请使用虚拟环境(virtualenv)。
开发
git clone https://github.com/MakazhanAlpamys/Soup.git
cd Soup
pip install -e ".[dev]"

ruff check src/soup_cli/ tests/    # lint
pytest tests/ -v                   # 单元测试(快速,无需 GPU)
pytest tests/ -m smoke -v          # 冒烟测试(下载一个小模型并训练)

pre-commit install                 # 可选:提交时运行 ruff lint+format
完整工作流程见 CONTRIBUTING.md;报告漏洞见 SECURITY.md。
支持 Soup
Soup 是 Apache-2.0 许可,完全免费——并将继续保持。它是在一台 4 GB 笔记本上开放构建和维护的, 这就是为什么本文档中的每个性能数字都是实测而非吹嘘。
如果 Soup 帮你省下了一次训练,给仓库点个 star 就是最大的帮助,而且零成本。如果你愿意直接资助这项工作:
❤️ 捐赠 —— 一次性,任意金额(在结账页 使用 Change amount 修改金额)。付款由 Stripe 以维护者注册的企业 MePlay, Inc. 处理—— 结账页和信用卡账单上显示的是这个名字,而不是 "Soup"。
捐赠将用于购买受硬件限制的工作所需的 GPU 算力——多 GPU、8B+ 验证、Apple Silicon—— 这些都是单台 4 GB 笔记本无法触达的。
另一种同样直接推动这些事项的方式,是硬件本身。这些工作都诚实地标着"需 <硬件>" 的门槛,
而不是未经证实的承诺。如果你能接触到更大的机器——或者有闲置的 GPU 额度——去跑一个
help wanted
问题并公布结果,与资助 GPU 算力同样有帮助。那些 issue 明确写着当前被硬件卡住的是什么。
贡献者
由社区共同构建 ❤️ —— 感谢每一位贡献者。见 CONTRIBUTORS.md。
联系
Bug 和功能请求请发到 issue tracker,问题请发到 Discussions——两者都能更快得到回复, 也能帮助遇到同样问题的下一个人。
如需实时聊天、搭建帮助,以及一切更适合对话形式的内容,请加入 Discord。 任何六个月后仍应可检索的内容,都应该放到 Issues 或 Discussions——Discord 的回答只帮一个人, 而 issue 能帮到所有遇到同样问题的人。行为准则同样适用。
对于不适合公开的内容——安全报告(见 SECURITY.md)、行为准则问题或媒体联系—— 请发送邮件至 team@trysoup.dev。这是项目官方地址,也是所有与 Soup 相关事项的正确联系方式。 makazanalpamys@gmail.com 是维护者的个人地址;同样能联系到同一个人,也是个不错的备选。
引用 Soup
Layer streaming——通过将冻结的主干模型从主机 RAM 中逐 decoder 层流式读出,在 4 GB 笔记本 GPU 上训练 8B 模型——在预印本中有详细描述,同时包含验证流式运行与常驻运行一致性的正确性协议 (前向和反向分开声明,因为这是两个声明,而不是一个)。
Makazhan, A. (2026). Exact Layer Streaming: LoRA Fine-Tuning of an 8B Model on a 4 GB Laptop GPU (v3). Zenodo. https://doi.org/10.5281/zenodo.21918325
当前版本为第 3 版(2026 年 8 月 13 日)。 标题和主张未变——8B 在 4 GB 上——自 v1 以来 没有任何实测数字变化。v3 所做的是撤回我们此前发布的一个解释,这也是描述这篇论文用途的最短方式:
- v3 中撤回的结论:"layer streaming 受限于主机到设备的传输,而不是 GPU。" 那是对下面 H100 复现实验的推断,从未被实测过。我们在 8 月 11 日测了它,在已发布的配置下 该结论不成立:删掉所有主机到设备的字节只省下 1.4%,计算流在一步中有 0.20% 的时间 在等待拷贝,而这步的运行速度是该卡同会话 GEMM 上限的 71.3%。最大的 streaming 特有开销 是逐层 NF4 反量化,占 9.8%(记录)。 所有测量数据都成立;复现以较弱的形式存活——该约束对两台机器是共同的,不是 GPU 的计算能力。
- 在与原实验毫无相似之处的硬件上复现(v2 新增):RTX 3050 上 119.6 tok/s,对比 H100 上的中位数 113.00,同样的 3.32 GB 峰值。
- 一个静默的错误梯度缺陷,被发现并修复。 在 NF4 每层约 165 MiB 以上时,前向保持一致, 损失曲线看起来正常,但梯度是错误的。根因已在上游库中定位并报告;修复已在真实 32B 和 72B 上用对照实验验证。