DreamServer

本地优先的全栈AI平台,一条命令即可部署LLM推理、聊天、语音、Agent、RAG、图像生成等全套服务,无需云服务或订阅。亮点在于硬件自动检测并选择合适的模型,支持NVIDIA、AMD、Apple Silicon、Intel Arc等多种GPU,提供扩展系统可自由添加服务,社区活跃且持续集成新功能。研究向,非商业用途建议。
README
Dream Server
掌控你的 AI。一人、一梦、一机。
少数几家公司控制着全球绝大多数的 AI 流量——随之而来的是你的数据、你的成本、你的可用性。你每次向集中式供应商发出的查询,都是你不拥有的商业情报,运行在你无法控制的基础设施上,定价于你无法谈判的条款上。
如果 AI 正在成为关键基础设施,它就不应该被租用。自托管本地 AI 应当是一项主权人权,而非职业选择。
Dream Server 就是那个出口。 一个本地优先的 AI 栈——LLM 推理、聊天、语音、代理、工作流、RAG、图像生成和隐私工具——通过一条命令部署在你的硬件上。无需云服务、无需订阅、无人监视。云和混合 API 模式在你选择时可选。


新来的? 阅读友好指南或收听音频版——完整介绍 Dream Server 是什么、如何工作以及如何让它成为你自己的。无需技术背景。
当前平台支持
平台 状态 Linux(NVIDIA + AMD + Intel Arc) 已支持——今天即可安装运行 Windows(NVIDIA + AMD) 已支持——今天即可安装运行 macOS(Apple Silicon) 已支持——今天即可安装运行 经过测试的 Linux 发行版: Ubuntu 24.04/22.04、Debian 12、Fedora 41+、Arch Linux、CachyOS、openSUSE Tumbleweed。其他使用 apt、dnf、pacman 或 zypper 的发行版也应可用——如果不行,请提交 issue。
Windows: 需要安装带 WSL2 后端的 Docker Desktop。NVIDIA GPU 使用 Docker GPU 直通;AMD Strix Halo 通过平台特定的加速路径运行,详见 Windows 安装程序和支持矩阵文档。
macOS: 需要 Apple Silicon(M1+)和 Docker Desktop。llama-server 原生运行并使用 Metal GPU 加速;所有其他服务在 Docker 中运行。
详情请参见支持矩阵。
为什么选择 Dream Server?
因为运行你自己的 AI 不应该需要计算机科学学位和花一整个周末调试 CUDA 驱动。目前,搭建本地 AI 意味着把十几个项目拼凑起来、从头编写 Docker 配置、并祈祷所有组件能相互通信。大多数人最终放弃,转回付费使用 OpenAI。
我们构建 Dream Server,就是为了让你不必如此。
- 一条命令 —— 检测你的 GPU,选择合适的模型,生成凭据,启动一切
- 在 2 分钟内开始聊天 —— 启动模式(bootstrap mode)让你瞬间得到一个可用的模型,同时完整模型在后台下载
- 完整的服务栈,开箱即用 —— 聊天、代理、语音、工作流、搜索、RAG、图像生成、隐私工具、可观测性和开发者工具,所有组件互相连通
- 完全可修改 —— 每个服务都是一个扩展。放入一个文件夹,运行
dream enable,搞定
curl -fsSL https://raw.githubusercontent.com/Light-Heart-Labs/DreamServer/main/dream-server/get-dream-server.sh | bash
打开 http://localhost:3000 并开始聊天。
API 端点: Linux Docker 安装默认将 llama-server 暴露在 http://localhost:11434(
OLLAMA_PORT),而容器内部使用llama-server:8080。macOS 原生 Metal 和 Windows 原生/Lemonade 路径使用 http://localhost:8080,除非另有覆盖。Open WebUI 保持使用 http://localhost:3000。
没有 GPU? Dream Server 也可以在云模式下运行——相同的完整栈,由 OpenAI/Anthropic/Together APIs 驱动,而非本地推理:
./install.sh --cloud
端口冲突? 每个端口都可通过环境变量配置。完整列表请参见
.env.example,或者在安装时覆盖:WEBUI_PORT=9090 ./install.sh
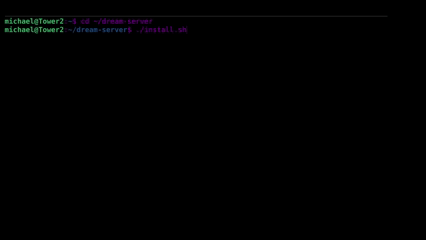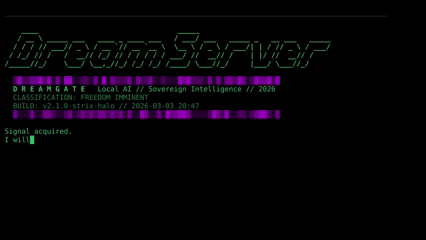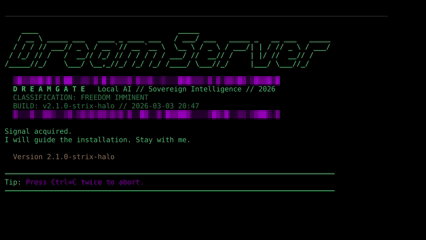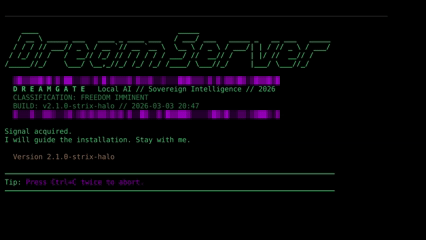
DREAMGATE 安装器负责一切——GPU 检测、模型选择、服务编排。
手动安装(Linux)git clone https://github.com/Light-Heart-Labs/DreamServer.git
cd DreamServer/dream-server
./install.sh
需要安装 Docker Desktop 并启用 WSL2 后端。 首先安装 Docker Desktop,确保它在运行后再开始。
打开一个普通 PowerShell 会话并运行:
Set-ExecutionPolicy -Scope Process -ExecutionPolicy Bypass
git clone https://github.com/Light-Heart-Labs/DreamServer.git
cd DreamServer
.\install.ps1
Set-ExecutionPolicy命令允许安装脚本在当前会话中运行。它不会更改你的系统范围策略。 不建议以管理员身份运行安装程序,因为用户级路径(如.opencode、data/、.env)可能会被创建为具有管理员所有权的权限。
安装程序会检测你的 GPU,选择合适的模型,生成凭据,启动所有服务,并在桌面创建指向仪表盘的快捷方式。使用 .\dream-server\installers\windows\dream.ps1 status 进行管理。
需要 Apple Silicon(M1+)和 Docker Desktop。 首先安装 Docker Desktop,确保它在运行后再开始。
git clone https://github.com/Light-Heart-Labs/DreamServer.git
cd DreamServer/dream-server
./install.sh
安装程序会检测你的芯片,为你的统一内存选择合适的模型,原生启动 llama-server 并使用 Metal 加速,然后在 Docker 中启动所有其他服务。使用 ./dream-macos.sh status 进行管理。
详情请参见 macOS 快速入门。
内含组件
聊天与推理
- Open WebUI —— 功能完备的聊天界面,支持对话历史、网络搜索、文档上传和30+ 语言
- llama-server —— 高性能 LLM 推理,支持连续批处理,为你的 GPU 自动选择;Linux Docker 主机 API 默认使用
localhost:11434,原生 macOS/Windows 路径使用localhost:8080,容器 API 运行在8080 - LiteLLM —— 支持本地/云/混合模式的 API 网关
- TEI Embeddings —— 用于 RAG 和搜索工作流的文本嵌入服务
语音
- Whisper —— 语音转文字
- Kokoro —— 文字转语音
代理与自动化
- Hermes Agent —— 可选的本地优先自主/浏览器代理,具备记忆、技能和魔法链接网关代理
- OpenClaw —— 可选的自主 AI 代理框架
- n8n —— 工作流自动化,集成 400+ 服务(Slack、邮件、数据库、API 等)
- APE —— 用于审计和管理自主工具调用的代理策略引擎(Agent Policy Engine)
- OpenCode —— 基于浏览器、连接到本地栈的 AI 编程助手
- Memory Shepherd —— 用于代理记忆生命周期管理的主机/systemd 辅助工具
知识与搜索
- Qdrant —— 用于检索增强生成(RAG)的向量数据库
- SearXNG —— 自托管网络搜索(无追踪)
- Perplexica —— 深度研究引擎
- Brave Search —— 可选的付费 Brave Search API 集成
创意
- ComfyUI —— 基于节点的图像生成
隐私与运维
- Privacy Shield —— 用于 API 调用的 PII(个人身份信息)擦除代理
- Dashboard —— 实时 GPU 指标、服务健康状态、模型管理
- Dashboard API —— 仪表盘背后的服务健康、设置、状态、指标和管理 API
- Token Spy —— 用于本地和代理的 LLM 流量的令牌使用监控器
- Langfuse —— 可选的 LLM 可观测性与追踪
硬件自动检测
安装程序自动检测你的 GPU 并选择最佳模型。默认路径无需手动配置。
当前模型映射默认使用 MODEL_PROFILE=qwen,另外支持 MODEL_PROFILE=gemma4 和 MODEL_PROFILE=auto(在支持 Gemma 4 的层级中)。使用 ./install.sh --tier 3 覆盖层级选择;使用 MODEL_PROFILE=gemma4 ./install.sh 或 MODEL_PROFILE=auto ./install.sh 覆盖模型家族。
NVIDIA
| 层级 | VRAM | Qwen 配置 | Gemma 4 配置 | 上下文长度 | 示例 GPU |
|---|---|---|---|---|---|
| 0 | < 8 GB 或仅 CPU 回退 | Qwen3.5 2B (Q4_K_M) | Qwen3.5 2B(适合启动的最小值) | 8K | 任何 GPU 或仅 CPU |
| 1 | 8–11 GB | Qwen3.5 9B (Q4_K_M) | Gemma 4 E2B IT (Q4_K_M) | 16K | RTX 4060, RTX 3060 12GB |
| 2 | 12–20 GB | Qwen3.5 9B (Q4_K_M) | Gemma 4 E4B IT (Q4_K_M) | 32K | RTX 3090, RTX 4080 |
| 3 | 20–40 GB | Qwen3 30B-A3B MoE (Q4_K_M) | Gemma 4 26B-A4B IT (Q4_K_M) | 32K Qwen / 16K Gemma | RTX 4090, A6000 |
| 4 | 40+ GB | Qwen3 30B-A3B MoE (Q4_K_M) | Gemma 4 31B IT (Q4_K_M) | 128K Qwen / 64K Gemma | A100, H100, 多 GPU |
| NV_ULTRA | 90+ GB | Qwen3 Coder Next (Q4_K_M) | Gemma 4 31B IT (Q4_K_M) | 128K | 多 GPU A100/H100 |
AMD Strix Halo(统一内存)
| 层级 | 统一内存 | Qwen 配置 | Gemma 4 配置 | 上下文长度 | 硬件 |
|---|---|---|---|---|---|
| SH_COMPACT | 64–89 GB | Qwen3 30B-A3B MoE (Q4_K_M) | Gemma 4 26B-A4B IT (Q4_K_M) | 128K Qwen / 64K Gemma | Ryzen AI MAX+ 395 (64GB) |
| SH_LARGE | 90+ GB | Qwen3 Coder Next (Q4_K_M) | Gemma 4 31B IT (Q4_K_M) | 128K | Ryzen AI MAX+ 395 (96GB) |
Apple Silicon(统一内存,Metal)
| 层级 | 统一内存 | Qwen 配置 | Gemma 4 配置 | 上下文长度 | 示例硬件 |
|---|---|---|---|---|---|
| 0 | < 16 GB | Qwen3.5 2B (Q4_K_M) | Qwen3.5 2B(适合启动的最小值) | 8K | M1/M2 基础款 (8GB) |
| 1 | 16–24 GB | Qwen3.5 9B (Q4_K_M) | Gemma 4 E2B IT (Q4_K_M) | 16K | M4 Mac Mini (16GB) |
| 2 | 32 GB | Qwen3.5 9B (Q4_K_M) | Gemma 4 E4B IT (Q4_K_M) | 32K | M4 Pro Mac Mini, M3 Max MacBook Pro |
| 3 | 48 GB | Qwen3 30B-A3B MoE (Q4_K_M) | Gemma 4 26B-A4B IT (Q4_K_M) | 32K Qwen / 16K Gemma | M4 Pro (48GB), M2 Max (48GB) |
| 4 | 64+ GB | Qwen3 30B-A3B MoE (Q4_K_M) | Gemma 4 31B IT (Q4_K_M) | 128K Qwen / 64K Gemma | M2 Ultra Mac Studio, M4 Max (64GB+) |
Intel Arc(Linux,SYCL)
| 层级 | VRAM | Qwen 配置 | Gemma 4 配置 | 上下文长度 | 示例硬件 |
|---|---|---|---|---|---|
| ARC_LITE | 6–11 GB | Qwen3.5 4B (Q4_K_M) | Gemma 4 E2B IT (Q4_K_M) | 16K | Arc A380, Arc A750 |
| ARC | 12+ GB | Qwen3.5 9B (Q4_K_M) | Gemma 4 E4B IT (Q4_K_M) | 32K | Arc A770 16GB, 较新 Arc GPU |
覆盖层级选择:./install.sh --tier 3
启动模式(Bootstrap Mode)
无需等待大型下载。Dream Server 默认使用启动模式:
- 在一分钟内下载一个 1.5B 的小模型
- 你立即开始聊天
- 完整模型在后台下载
- 准备好后热切换到完整模型——零停机
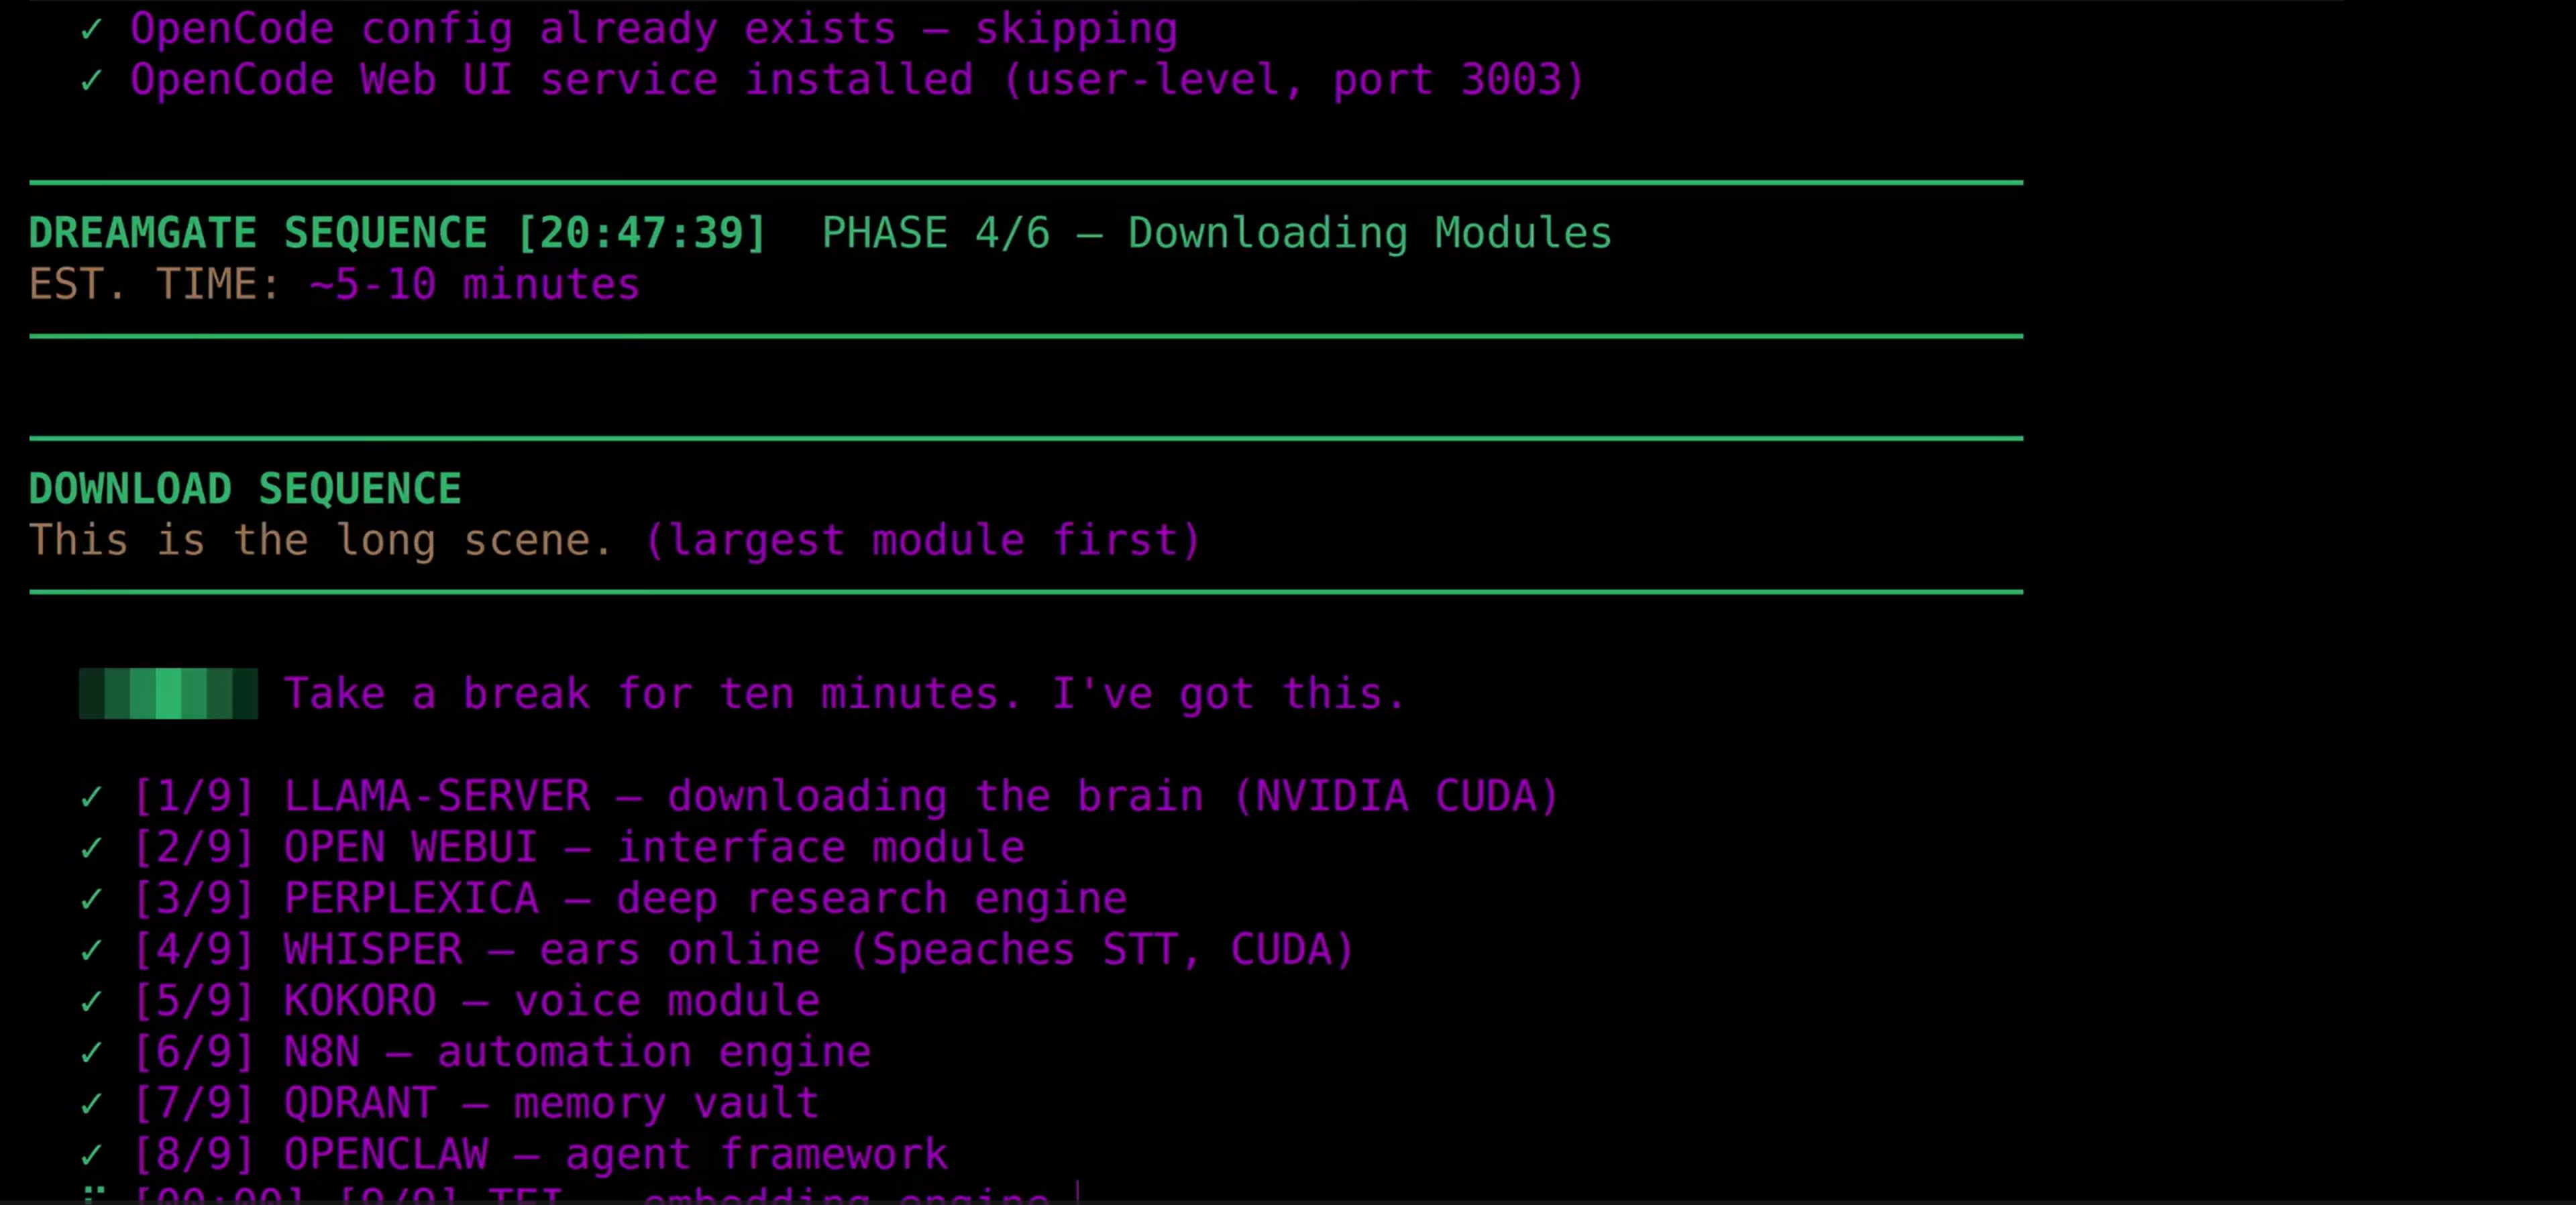
安装器并行拉取所有服务。下载支持断点续传——中断的下载会从中断处继续。
跳过启动模式:./install.sh --no-bootstrap
切换模型
安装程序会为你的硬件选择一个模型,但你可以随时切换:
dream model current              # 当前正在运行什么?
dream model list                 # 显示所有可用层级
dream model swap T3              # 切换到不同的层级
如果新模型尚未下载,先预取它:
./scripts/pre-download.sh --tier 3    # 在切换前下载
dream model swap T3                    # 然后切换(重启 llama-server)
已有想用的 GGUF 模型?将其放入 data/models/,更新 .env 中的 GGUF_FILE 和 LLM_MODEL,然后使用 CLI 重启:
dream restart llm
或者直接从已安装的 dream-server 目录重启容器:
docker compose restart llama-server
回滚是自动的——如果新模型加载失败,Dream Server 会恢复到之前的模型。
可扩展性
Dream Server 设计为可修改。每个服务都是一个扩展——一个包含 manifest.yaml 和 compose.yaml 的文件夹。仪表盘、CLI、健康检查和 compose 栈都会自动发现扩展。
extensions/services/
  my-service/
    manifest.yaml      # 元数据:名称、端口、健康端点、GPU 后端
    compose.yaml       # Docker Compose 片段(自动合并到栈中)
dream enable my-service     # 启用
dream disable my-service    # 禁用
dream list                  # 查看所有
安装程序本身也是模块化的——6 个库和 13 个阶段,每个都在单独的文件中。想添加硬件层级、替换默认模型或跳过某个阶段?编辑一个文件即可。
dream-cli
dream CLI 管理你的整个栈:
dream status                # 健康检查 + GPU 状态
dream list                  # 所有服务及其状态
dream logs llm              # 查看日志(别称:llm, stt, tts)
dream restart [service]     # 重启一个或所有服务
dream start / stop          # 启动或停止栈

dream mode cloud            # 切换到通过 LiteLLM 使用云 API
dream mode local            # 切换回本地推理
dream mode hybrid           # 本地为主,云为回退

dream model swap T3         # 切换到不同的硬件层级
dream enable n8n            # 启用一个扩展
dream disable whisper       # 禁用一个

dream config show           # 查看 .env(密钥会被遮盖)
dream preset save gaming    # 快照当前配置
dream preset load gaming    # 恢复配置
与其他工具的对比
其他工具只能让你走一部分路。Dream Server 带你走完全程。
| Dream Server | Ollama + Open WebUI | LocalAI | |
|---|---|---|---|
| 范围 | 完整的 AI 栈——从推理到代理到工作流 | LLM + 聊天 | 仅 LLM |
| 一键安装 | 所有组件,自动配置 | 仅 LLM + 聊天 | 仅 LLM |
| 硬件自动检测 + 模型选择 | NVIDIA + AMD Strix Halo + Apple Silicon + Intel Arc + CPU/云回退 | 否 | 否 |
| AMD APU 统一内存支持 | 平台特定的加速后端,由安装程序选择 | 部分(Vulkan) | 否 |
| 自主 AI 代理 | Hermes Agent / OpenClaw | 否 | 否 |
| 工作流自动化 | n8n(400+ 集成) | 否 | 否 |
| 语音(STT + TTS) | Whisper + Kokoro | 否 | 否 |
| 图像生成 | ComfyUI | 否 | 否 |
| RAG 流水线 | Qdrant + 嵌入 | 否 | 否 |
| 扩展系统 | 基于清单,热插拔 | 否 | 否 |
| 多 GPU | 是(NVIDIA) | 部分 | 部分 |
文档
| 快速入门 | 带故障排除的逐步安装指南 |
| 无头设置 | QR 码入门、首次启动设置、AP 模式、mDNS 和本地代理访问 |
| 硬件指南 | 购买建议、层级推荐 |
| 常见问题 | 常见问题与配置 |
| 扩展 | 如何添加自定义服务 |
| 安装器架构 | 模块化安装器深入介绍 |
| 更新日志 | 版本历史与发布说明 |
| 贡献指南 | 如何参与贡献 |
英雄墙
Dream Server 的存在是因为人们选择去构建而非等待。这里的每一位贡献者都是超越代码的更大事业的一部分——在不断增加的抗争中,反对 AI 应被租用、设门和由少数人控制的想法。他们是主权 AI 运动的奠基者,证明一人、一机、一梦足以改变世界。
感谢 kyuz0 的 amd-strix-halo-toolboxes——为 Strix Halo 预构建的 ROCm 容器,省去了我们自己构建的很多痛苦。感谢 lhl 的 strix-halo-testing——整个社区赖以建立的基础性 Strix Halo AI 研究和 rocWMMA 性能工作。
Tony363 (Tony Siu) 非常关心我们的使命,并一直是帮助我们获得全球可见性和支持的重要盟友。他最大的贡献在于他是一个相信本地 AI 和大众赋权、希望看到我们成功的人。
社区构建
- halo-ai (bong-water-water-bong) —— 在 Arch Linux 上为 Strix Halo 进行的裸机 DreamServer 重建。零容器,从源码编译,89 tok/s。证明了生成方面 Vulkan 优于 ROCm(gfx1151),并向生态贡献了内核调优研究(
amd_iommu=off、TTM 页面池扩展)。DreamServer 的早期倡导者,将我们介绍给了 Lemonade SDK 社区和 AMD 开发者团队。
成就 Dream Server 的项目
- llama.cpp (ggerganov) —— LLM 推理引擎
- Qwen (阿里云) —— 默认语言模型
- Open WebUI —— 聊天界面
- ComfyUI —— 图像生成引擎
- FLUX.1 (Black Forest Labs) —— 图像生成模型
- AMD ROCm —— GPU 计算平台
- AMD Strix Halo Toolboxes (kyuz0) —— 为 AMD 推理预构建的 ROCm 容器
- Strix Halo Testing (lhl) —— 基础性 Strix Halo AI 研究和 rocWMMA 优化
- n8n —— 工作流自动化
- Qdrant —— 向量数据库
- SearXNG —— 尊重隐私的搜索
- Perplexica —— 基于 AI 的搜索
- LiteLLM —— LLM API 网关
- Kokoro FastAPI (remsky) —— 文字转语音
- Speaches —— 语音转文字
- Strix Halo Home Lab —— 社区知识库
抵抗者
- Yasin Bursali (yasinBursali) —— DreamServer 最多产的贡献者,合并了 80+ 个 PR,涉及栈的每一层。扩展门户:构建了完整的扩展生命周期系统——带 CI 新鲜度验证的目录生成器、用于在 Docker 外管理容器的 dream host agent(时序安全认证、核心服务保护、每服务锁定、设置钩子执行)、具有 16 项检查的 compose 安全扫描器的扩展 API(阻止特权模式、docker socket 挂载、危险能力、主机命名空间、非 localhost 端口绑定)以及带路径遍历和符号链接保护的原子安装、扩展仪表盘页面(安装/启用/禁用/卸载)和全面的 API/主机代理/运行时生命周期文档。扩展库强化:领导了三轮 50+ 个 PR,标准化所有 33 个扩展清单——安全强化(localhost 绑定、凭据要求、会话隔离)、设置钩子、镜像摘要锁定、健康检查修复(IPv4 迁移、工具可用性、拆分端点的 health_port)、端口冲突解决、README 标准化、平台兼容性矩阵、功能 ID 去重以及裸端口和 security_opt 标准化的 compose 安全扫描绕过关闭。macOS 可移植性:修复了 Apple Silicon Neural Engine 检测、统一内存 VRAM 门控、GPU_BACKEND=apple 对齐、BSD/GNU sed 兼容性(
_sed_i)、可移植时间戳(_now_ms())、带 Homebrew 重新执行的 Bash 4+ 保护、原生 llama-server 的就绪 sidecar、LaunchAgent 主机代理集成和 WSL2 主机 RAM 检测。仪表盘 API:添加了分层 Privacy Shield 认证、将 privacy-shield 切换从 Docker socket 迁移到主机代理 API、填充了空状态字段(磁盘/系统/推理)、修复了带共享 aiohttp 会话的 n8n 健康检测、强制健康检查器使用 IPv4(针对 WSL2)、从 nvidia-smi 进程添加 GPU 服务推理回退、处理推理模型<think>块,并修复了从 .env 读取的版本端点。安装器/CLI:将已弃用的 n8n 基本认证替换为 v2.x 管理设置、在模型交换时保留 .env 的 inode(使用 cat > 而非 mv)、在 /etc/os-release 源化时保留 VERSION、修复了 dream-cli 符号链接解析、防止了扩展 compose 文件的重复包含、向停止/启动/重启添加了 load_env、在图像生成关闭时禁用 ComfyUI compose、修复了 COMPOSE_FLAGS 的词拆分、向 dream disable 添加了反向依赖检查,并向 CI 固定件添加了 SEARXNG_SECRET。安全性:使用回环绑定和无新权限强化了 ComfyUI、使用自动生成密码保护了 OpenCode、从 token-spy HTML 移除了 API 密钥、向安装器添加了set -euo pipefail,并在 MIG/vGPU 配置上保护了 nvidia-smi 不出现 [N/A] 值。可观测性(2026 年 4 月):向主机代理添加了带 Docker stats 解析和 IEC 单元处理的每容器 CPU/内存统计端点、添加了通过 Docker Compose 项目标签过滤、限定于 dream-server 容器的只读服务日志端点、将仪表盘日志查看路由通过主机代理,带有状态码钳位(502 表示上游错误)和 Docker Compose 标签欺骗预防、添加了带并行获取和分 TTL 缓存的每服务资源指标聚合端点、添加了带后台文件大小监视器和原子 JSON 状态写入的实时启动下载进度追踪、添加了带旧模型回退(健康检查失败时)和 PID 重用验证的 macOS 原生 llama-server 热切换。CLI/安装器修复:修复了 dream-cli 版本显示以从 .env 而非硬编码 2.0.0 读取、向服务注册表添加了用户扩展目录扫描,带内置优先去重、用通过 resolve-compose-stack 的适当重新生成替换了 compose-flags 缓存删除、修复了单 GPU NVIDIA 系统的 GPU 分配 JSON 生成、在第 11 阶段容器启动前添加了 compose 语法验证、向 15 个扩展清单添加了 dream_min 版本界限,并在安装器中预创建了 privacy-shield 数据目录。 - Youness Yachouti (y-coffee-dev) —— 设计并构建了全栈多 GPU 系统:通过 nvidia-smi topo 矩阵解析的 NVIDIA 拓扑检测、带拓扑感知服务放置的四阶段 GPU 分配算法、docker-compose.multigpu.yml 覆盖生成,以及仪表盘 GPU 监控页面(每 GPU 卡片、SVG 迷你折线图、拓扑可视化和服务分配视图)。添加了五个 dream gpu CLI 子命令(status, topology, assignment, validate, reassign),带 --auto/--manual/--dry-run 模式和 bash 标签补全。重写了 lib/safe-env.sh,使其仅在第一个 = 处拆分,修复了 .env 解析中的 base64 值截断。向 dashboard-api 添加了 GPU 环境传递、禁用 ComfyUI 时的 SDXL 下载防护,以及 nvidia-smi 输出的 ANSI 转义序列剥离。贡献了 345 行 GPU 特定测试。在实际多 GPU 硬件上测试,包括 4x RTX 4060 Ti、4x RTX 4080 和 8x RTX 5060 Ti 配置。
- Tony363 (Tony Siu) —— 将 dashboard-api 的测试覆盖率提升至 95%,跨 14 个文件编写了 3500+ 行测试,涵盖设置、隐私、工作流、更新、代理和 GPU 监控的全面端点覆盖,以及 7 个 BATS shell 测试套件,覆盖日志、常量、path-utils、bootstrap-model、nvidia-topo、ui 和 background-tasks。添加了全面的架构概览文档(ARCHITECTURE.md),包含服务拓扑、安装器流水线和 compose 分层的 Mermaid 图。修复了阻塞每个 PR 前端检查的已有 ThemeProvider CI 失败。报告了 Manjaro/Arch 上的 PyYAML 导入崩溃(resolve-compose-stack.sh),并给出了清晰的根因分析。作为 Coffee and Code Philadelphia 的负责人,推动开发者推广和生态增长。早期工作:强化了 service-registry.sh 防止 shell 注入、改进了带有 Luhn 检查的 PII 擦除器、使用原子写入修复了 token-spy 设置持久化、修复了 session-manager.sh 中的 SSH 命令注入、在 dashboard-api 中收窄了宽泛的异常捕获,并撰写了包含项目说明和设计理念的 CLAUDE.md。构建了三个由 AI 驱动的 GitHub Actions 工作流:带有 fork 检测和受保护文件执行的整合代码审查、带标签门控的 issue 到 PR 自动化(4 作业流水线:验证/实现/防护栏/创建 PR),带有提示注入强化(反注入序言、4000 字符截断、工具限制、秘密扫描),以及每晚 AI 扫描器用于代码审查/文档/自主扫描,带有预算上限和仅手动触发。在 Strix Halo 的 GPU 检测中修复了统一 APU 名称回退。原型化了完整的 Rust/Axum 重写 dashboard-api,包含 285 个测试、恒定时间认证中间件、3-crate 工作区和约 25MB Docker 镜像(进行中——扩展安全功能正在移植)。为 Arch/Manjaro 兼容性修复了安装器阶段 13 中 pipefail 安全的主机名回退。
- latentcollapse (Matt C) —— 安全审计与强化:OpenClaw localhost 绑定修复、多 GPU VRAM 检测、AMD 仪表盘强化,以及 Agent Policy Engine (APE) 扩展。
- Igor Lins e Silva (igorls) —— 稳定性审计,修复了 9 个基础设施 bug:备份/恢复/更新脚本中的动态 compose 发现、Token Spy 持久化存储和连接池强化、dotglob 回退修复、systemd 自动恢复服务修正、为设置向导兼容性移除了预检端口端点的认证门、为仪表盘添加了 ESLint flat 配置、清理了 Python 代码库中未使用的导入和 lint,并解决了仪表盘和冒烟测试的 CI 失败。
- Nino Skopac (NinoSkopac) —— Token Spy 仪表盘改进:共享指标标准化及等价性测试、预算和活跃会话跟踪、可配置的安全 CORS 替代通配符来源,以及用于 sidecar 迁移的 DB 后端兼容性垫片。
- Glexy (fullstackdev0110) —— 添加了扩展运行时检查脚本,用于验证非核心服务的 Docker 状态和可选的 HTTP 健康,将其集成到安装摘要阶段和 CI 工作流