esm

蛋白质生物学基础模型系统,包含蛋白质语言模型 ESMC、结构预测模型 ESMFold2 以及覆盖 68 亿蛋白质的 ESM Atlas 图谱。ESMC 在长程结构理解上超越前代 ESM2,ESMFold2 在蛋白-蛋白相互作用设计上达到 SOTA,并支持单序列快速折叠。同时通过稀疏自编码器(SAE)实现了模型内部表示的可解释性。值得关注的原因是该系统整合了从序列到结构再到功能发现的完整管线,并附有实验室验证的 binder 设计案例。MIT 许可,开放权重和代码。
README
蛋白质生物学的世界模型:ESMC、ESMFold2 与 ESM Atlas
ESMC & ESMFold2 预印本 ⋅ Atlas ⋅ 教程 ⋅ Slack
我们正在发布一个蛋白质生物学的世界模型:一个用于预测、设计和发现的科学引擎。该系统基于最新一代的 Evolutionary Scale Modeling(ESM)构建,从进化产生的蛋白质序列中学习,并利用这些知识在多个尺度上表示、映射、预测和设计蛋白质——从原子相互作用到跨越数十亿年的进化关系。该系统包含三个组件:ESMC、ESMFold2 和 ESM Atlas。
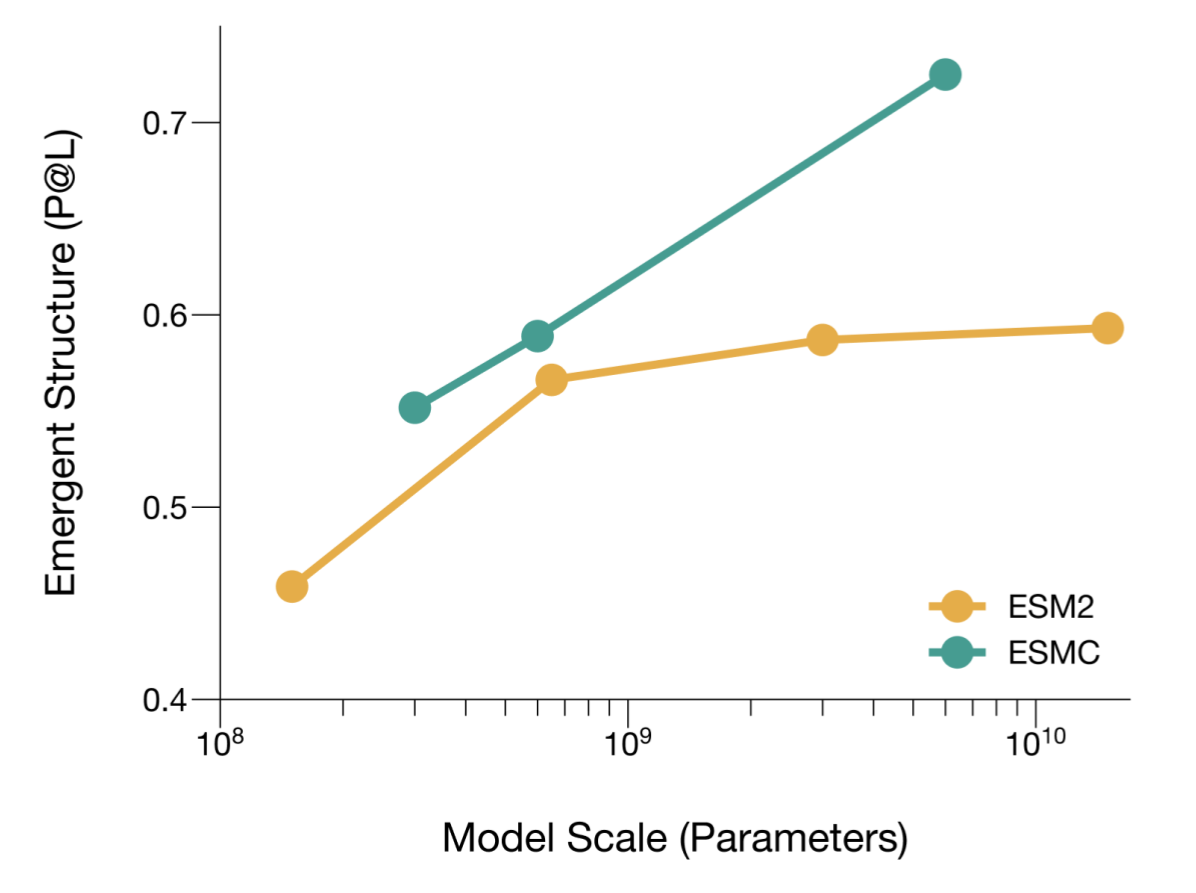
ESMC 是一个最先进的蛋白质语言模型,它通过训练数十亿条蛋白质序列学会了蛋白质生物学的规则。与 ESM2 相比,ESMC 定义了一个新的 Scaling(规模化)前沿,随着模型规模的增大,在突现的长程结构理解方面实现了更强的性能。
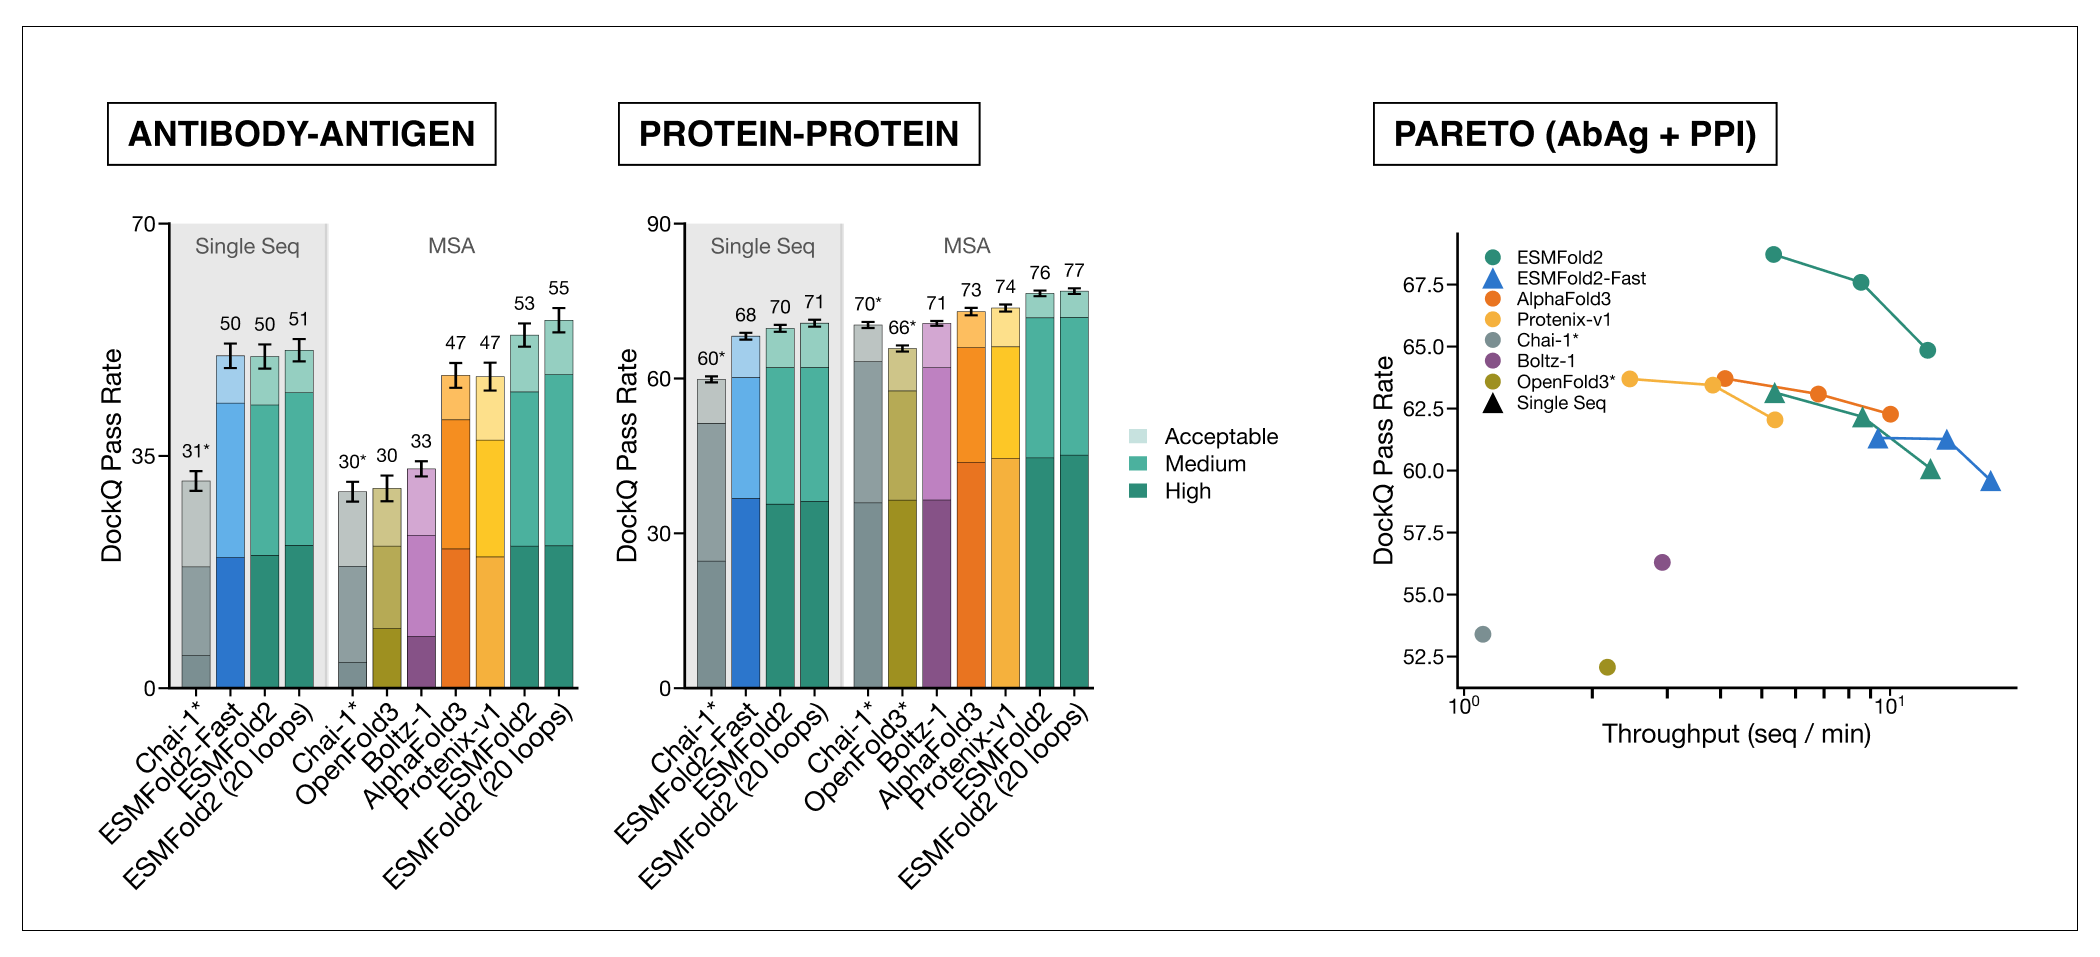
ESMFold2 基于 ESMC 6B 模型构建,是一个最先进的结构预测模型,已在蛋白质-蛋白质相互作用的设计中经过验证。ESMFold2 在 Foldbench 蛋白质-蛋白质和抗体-抗原复合物上的 DockQ 通过率方面超越了其他模型,并且可以在单序列模式下使用,实现数量级的折叠加速。
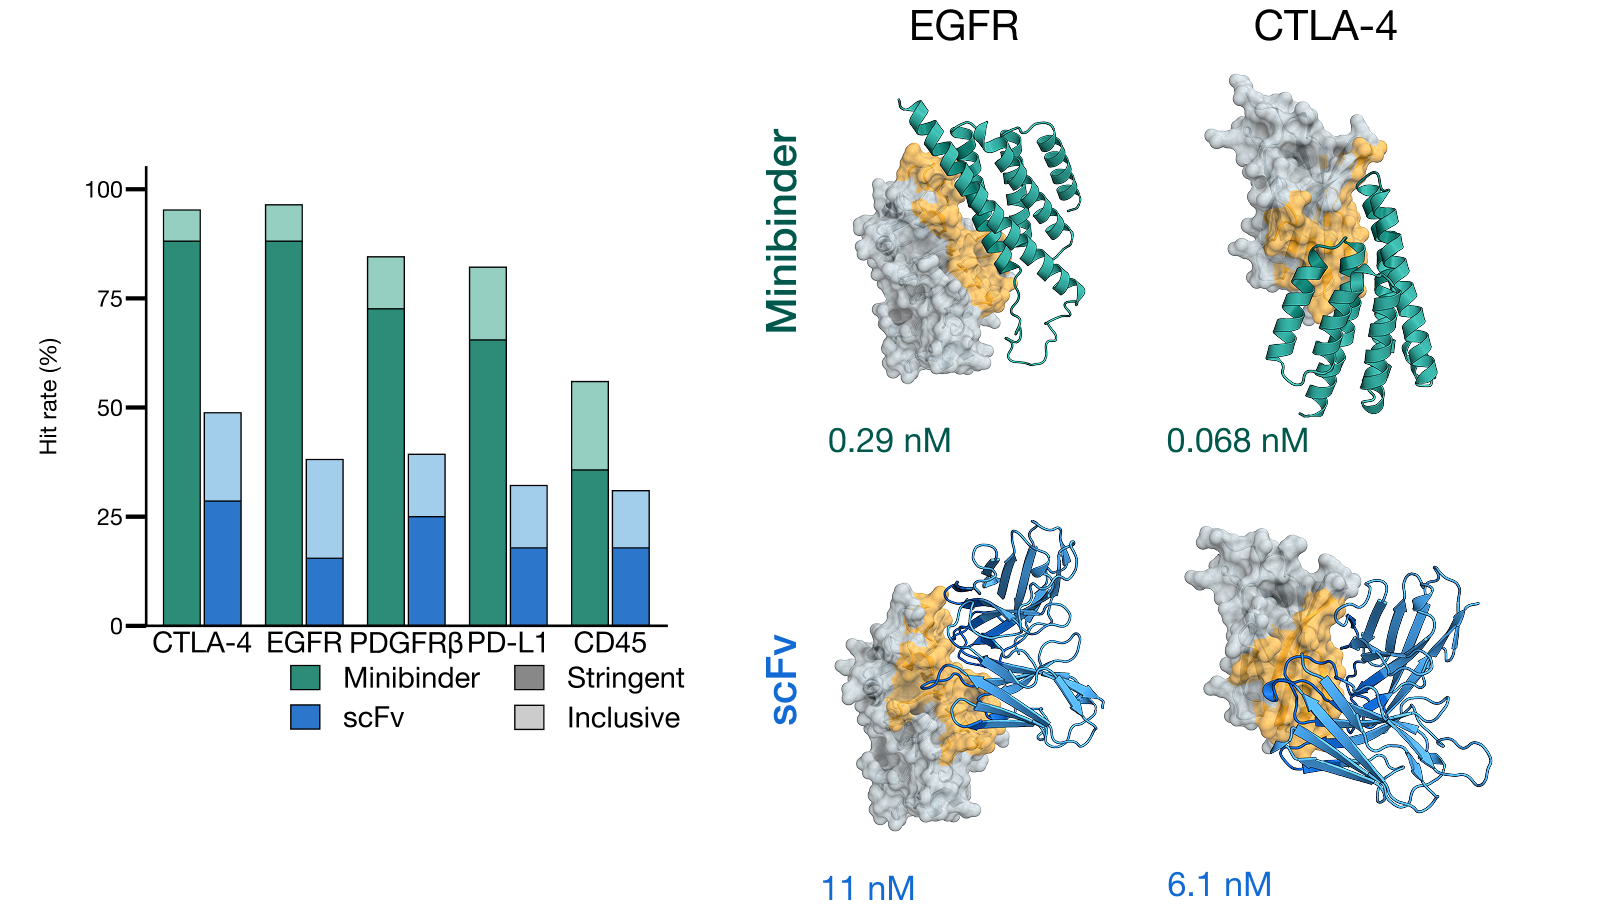
ESMFold2 已在实验室针对五个治疗靶点进行了验证。通过反转 ESMFold2,可以生成具有高命中率、纳摩尔级亲和力、靶点特异性和功能活性的全新微型结合剂和抗体衍生 scFv。我们计划发布一个 notebook,完整介绍从靶点序列到排序后的候选结合剂的设计循环。完整的方案也在预印本中进行了描述。
ESM Atlas 是一张涵盖生命全部生物多样性的 68 亿个蛋白质的图谱。ESMFold2 的折叠通量使得预测超过十亿个预测结构成为可能。Atlas 根据 ESMC 的内部世界模型进行组织。我们通过训练稀疏自编码器(SAE)使这个世界模型可解释。SAE 是无监督神经网络,经过训练可将 ESMC 的内部表示分解为一组约 16,000 个稀疏的可解释特征,揭示 ESMC 学习到的蛋白质之间的功能关系。每个特征都通过一个基于 Agent(智能体)的流程用自然语言进行总结,该流程将特征映射到蛋白质数据库中已知的生物学知识。我们发布了一组在不同模型规模、不同层以及不同粒度级别上训练的 SAE。了解更多关于如何在 Biohub Platform 上使用 ESM Atlas 的信息。
关于如何使用 ESM3,请参阅 ESM3 README。
目录
ESMC
ESMC 是一个最先进的蛋白质语言模型,它通过训练数十亿条蛋白质序列学习到了蛋白质生物学的表示。
ESMC 的代码库、模型权重和模型变体可通过 Hugging Face 获取。
运行 ESM 模型主要有两种方式:通过 Biohub Platform 或通过 Hugging Face 在本地运行。Biohub Platform 使用户能够以最少的设置轻松运行 ESM 模型的推理。有兴趣自定义或微调 ESM 模型的用户可以使用 Hugging Face 上的模型。
本地运行 ESMC
从 GitHub 安装 esm(PyPI 版本即将发布):
pip install esm@git+https://github.com/Biohub/esm.git@c94ed8d
以下代码演示了如何在本地运行 ESMC:
import torch
from transformers import AutoModelForMaskedLM, AutoTokenizer
from huggingface_hub import login

# 使用你的 Hugging Face 凭据登录
login()

# 示例 GFP 序列
sequences = ["MSKGEELFTGVVPILVELDGDVNGHKFSVSGEGEGDATYGKLTLKFICTTGKLPVPWPTLVTTFSYGVQCFSRYPDHMKQHDFFKSAMPEGYVQERTIFFKDDGNYKTRAEVKFEGDTLVNRIELKGIDFKEDGNILGHKLEYNYNSHNVYIMADKQKNGIKVNFKIRHNIEDGSVQLADHYQQNTPIGDGPVLLPDNHYLSTQSALSKDPNEKRDHMVLLEFVTAAGITHGMDELYK"]

model = AutoModelForMaskedLM.from_pretrained(
    "Biohub/ESMC-6B",
    device_map="auto",
).eval()
tokenizer = AutoTokenizer.from_pretrained("Biohub/ESMC-6B")

inputs = tokenizer(sequences, return_tensors="pt", padding=True)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
with torch.inference_mode():
    output = model(**inputs)
默认情况下,模型仅返回最后一层的表示。要返回所有 Transformer 层的隐藏状态,请设置:
output = model(**inputs, output_hidden_states=True)
通过 Biohub Platform 运行 ESMC
以下代码展示了如何使用 Biohub Platform 访问 ESMC。API 令牌可以在开发者控制台中创建。
请注意,我们的 API 已从 forge.evolutionaryscale.ai 迁移至 biohub.ai,因此某些代码类中仍引用 "Forge"。
要开始使用 ESM,请使用 pip 安装 Python 库:
pip install esm@git+https://github.com/Biohub/esm.git@c94ed8d
然后导入必要的库并实例化你想要的模型。
from esm.sdk import esmc_client
from esm.sdk.api import ESMProtein, LogitsConfig

# 人碳酸酐酶 II (PDB 2CBA)
protein = ESMProtein(
    sequence=(
        "MSHHWGYGKHNGPEHWHKDFPIAKGERQSPVDIDTHTAKYDPSLKPLSVSYDQATSLRILNNGHAFNVEFDD"
        "SQDKAVLKGGPLDGTYRLIQFHFHWGSLDGQGSEHTVDKKKYAAELHLVHWNTKYGDFGKAVQQPDGLAVL"
        "GIFLKVGSAKPGLQKVVDVLDSIKTKGKSADFTNFDPRGLLPESLDYWTYPGSLTTPPLLECVTWIVLKEP"
        "ISVSSEQVLKFRKLNFNGEGEPEELMVDNWRPAQPLKNRQIKASFK"
    )
)
model = esmc_client(
    model="esmc-600m-2024-12", url="https://biohub.ai", token="<your API token>"
)

protein_tensor = model.encode(protein)
logits_output = model.logits(
    protein_tensor, LogitsConfig(sequence=True, return_embeddings=True)
)

print(logits_output.logits, logits_output.embeddings)
关于如何使用 ESMC 的教程,请参阅我们的教程。
ESMC 稀疏自编码器(SAE)
稀疏自编码器(SAE)是一种无监督方法,用于将大型 Transformer 语言模型的表示分解为可解释的单元。我们发布了在 ESMC 上训练的 SAE,以揭示 ESMC 世界模型学习到的功能组织的可解释单元。
Atlas 中使用的以及在论文中分析的稀疏自编码器 ESMC-6B-sae-layer60-k64-codebook16384 基于 ESMC 6B 模型。我们还为该 SAE 的码本提供了人类可解释的、由 Agent 生成的特征描述。
ESMC SAE 的代码库、模型权重和模型变体可通过 Hugging Face 获取。
import torch
from transformers import AutoModel, AutoTokenizer

sequence = "MGSNKSKPKDASQRRRSLEPAENVHGAGGGAFPASQTPSKPASADGHRGPSAAFAPAAAEPKLFGGFNSSDTVTSPQRAGPLAGGVTTFVALYDYESRTETDLSFKKGERLQIVNNTEGDWWLAHSLSTGQTGYIPSNYVAPSDSIQAEEWYFGKITRRESERLLLNAENPRGTFLVRESETTKGAYCLSVSDFDNAKGLNVKHYKIRKLDSGGFYITSRTQFNSLQQLVAYYSKHADGLCHRLTTVCPTSKPQTQGLAKDAWEIPRESLRLEVKLGQGCFGEVWMGTWNGTTRVAIKTLKPGTMSPEAFLQEAQVMKKLRHEKLVQLYAVVSEEPIYIVTEYMSKGSLLDFLKGETGKYLRLPQLVDMAAQIASGMAYVERMNYVHRDLRAANILVGENLVCKVADFGLARLIEDNEYTARQGAKFPIKWTAPEAALYGRFTIKSDVWSFGILLTELTTKGRVPYPGMVNREVLDQVERGYRMPCPPECPESLHDLMCQCWRKEPEERPTFEYLQAFLEDYFTSTEPQYQPGENL"

model = AutoModel.from_pretrained("Biohub/ESMC-6B", device_map="auto").eval()
tokenizer = AutoTokenizer.from_pretrained("Biohub/ESMC-6B")
sae = AutoModel.from_pretrained(
    "Biohub/ESMC-6B-sae-k64-codebook16384",
    allow_patterns=["config.json", "layer_30.safetensors", "layer_60.safetensors"],
    device=model.device,
)
sae.initialize_layers([30, 60])
model.add_sae_models([sae.layers["30"], sae.layers["60"]])

inputs = tokenizer(sequence, return_tensors="pt", padding=True)
inputs = {k: v.to(model.device) for k, v in inputs.items()}

with torch.inference_mode():
    output = model(**inputs)

output["sae_outputs"]["layer60"]  # sparse.coo tensor
print(output["sae_outputs"]["layer60"].shape)
关于如何使用 ESMC SAE 的教程,请参阅我们的教程。
ESMFold2
ESMFold2 是一个最先进的蛋白质结构预测模型,它将 ESMC(6B 参数)语言模型嵌入与基于扩散的结构预测架构相结合。
该模型直接根据氨基酸序列预测高分辨率、全原子 3D 蛋白质结构,并可选择性地输入多序列比对(MSA)以提高在困难靶点上的准确性。ESMFold2 实现了最先进的性能,在多个评估数据集上匹配或超过 AlphaFold3,同时通过优化扩散采样和架构创新提供了更高的计算效率。
ESMFold2 的代码库、模型权重和模型变体可通过 Hugging Face 获取。
本地运行 ESMFold2
from esm.models.esmfold2 import (
    DNAInput,
    ESMFold2InputBuilder,
    LigandInput,
    Modification,
    ProteinInput,
    StructurePredictionInput,
)
from transformers.models.esmfold2.modeling_esmfold2 import ESMFold2Model

HHAI_SEQ = (
    "MIEIKDKQLTGLRFIDLFAGLGGFRLALESCGAECVYSNEWDKYAQEVYEMNFGEKPEGDITQVNEKTIPDH"
    "DILCAGFPCQAFSISGKQKGFEDSRGTLFFDIARIVREKKPKVVFMENVKNFASHDNGNTLEVVKNTMNELD"
    "YSFHAKVLNALDYGIPQKRERIYMICFRNDLNIQNFQFPKPFELNTFVKDLLLPDSEVEHLVIDRKDLVMTN"
    "QEIEQTTPKTVRLGIVGKGGQGERIYSTRGIAITLSAYGGGIFAKTGGYLVNGKTRKLHPRECARVMGYPDS"
    "YKVHPSTSQAYKQFGNSVVINVLQYIAYNIGSSLNFKPY"
)

model = ESMFold2Model.from_pretrained("biohub/ESMFold2").cuda().eval()

spi = StructurePredictionInput(
    sequences=[
        ProteinInput(id="A", sequence=HHAI_SEQ),
        DNAInput(
            id="B",
            sequence="GATAGCGCTATC",
            modifications=[Modification(position=5, ccd="C36")],
        ),
        DNAInput(
            id="C",
            sequence="TGATAGCGCTATC",
            modifications=[Modification(position=6, ccd="C36")],
        ),
        LigandInput(id="L", ccd=["SAH"]),
    ]
)

result = ESMFold2InputBuilder().fold(
    model, spi, num_loops=3, num_sampling_steps=50, num_diffusion_samples=1, seed=0
)

print(f"pLDDT mean: {float(result.plddt.mean()):.3f}, pTM: {float(result.ptm):.3f}, ipTM: {float(result.iptm):.3f}")

with open("1mht_pred.cif", "w") as f:
    f.write(result.complex.to_mmcif())
通过 Biohub Platform 运行 ESMFold2
安装 esm Python 包
pip install esm@git+https://github.com/Biohub/esm.git@c94ed8d
导入必要的库。
from esm.sdk.forge import SequenceStructureForgeInferenceClient
from esm.sdk.api import FoldingConfig
from esm.utils.structure.input_builder import ProteinInput, StructurePredictionInput
使用所选模型调用推理客户端,并将 <your API token> 替换为你的令牌名称。
client = SequenceStructureForgeInferenceClient(model="esmfold2-fast-2026-05", url="https://biohub.ai", token="<your API token>")

# 人碳酸酐酶 II (PDB 2CBA)
ca2_sequence = (
    "MSHHWGYGKHNGPEHWHKDFPIAKGERQSPVDIDTHTAKYDPSLKPLSVSYDQATSLRILNNGHAFNVEFDD"
    "SQDKAVLKGGPLDGTYRLIQFHFHWGSLDGQGSEHTVDKKKYAAELHLVHWNTKYGDFGKAVQQPDGLAVL"
    "GIFLKVGSAKPGLQKVVDVLDSIKTKGKSADFTNFDPRGLLPESLDYWTYPGSLTTPPLLECVTWIVLKEP"
    "ISVSSEQVLKFRKLNFNGEGEPEELMVDNWRPAQPLKNRQIKASFK"
)
ca2_input = StructurePredictionInput(
    sequences=[ProteinInput(id="A", sequence=ca2_sequence)]
)

config = FoldingConfig(num_loops=3, num_sampling_steps=32)
result = client.fold_all_atom(ca2_input, config=config)

with open("result.cif", "w") as f:
    f.write(result.complex.to_mmcif())
关于如何使用 ESMFold2 的教程,请参阅我们的教程。
前沿安全
Biohub 已建立了一个安全团队,在发布前评估我们模型和工具的益处及潜在风险,并在必要时制定缓解措施。为此,我们遵循一种结构化方法,包括评估生物安全和生物安保风险,以及现有的、可比较的开源模型和工具。我们积极与科学界、利益相关者和领域专家合作,以推动创新以及负责任的开发的最佳实践。我们已对本版本中的每个组件进行了风险评估,包括我们的 ESMC Cambrian 模型、ESMFold2、ESMC SAE、ESM Atlas 和 Binder 设计系统。
根据我们的风险评估,我们发布了 ESMC 6B、ESMFold2 和 ESMC SAE 的源代码和模型权重。我们还公开了我们的 ESM Atlas 数据集和 Binder 设计系统。Biohub 重视开放科学,我们与科学界分享我们的研究,以便其他人可以评估、复现并基于我们的工作进行构建。
评估:在发布前,我们进行了评估,以了解针对特定滥用相关的功能性任务的能力提升情况。这些评估的完整细节可在我们相应的论文附录中找到。
Biohub Platform:我们在免费访问的平台上实施护栏,检测并限制对应受控病原体和毒素的关键词和序列的使用。关于这些护栏的更多详细信息,请参阅我们的 Biohub Platform 资源页面。我们认识到使用 AI 模型来理解和建模这些序列和蛋白质有许多正当理由。如果你的工作受到这些护栏影响,你可以通过 Biohub.ai 申请平台的高级访问权限。
使用模型时,请遵守我们的可接受使用政策。
许可证
这些模型根据 MIT 许可证 提供。
引用
如果在你的工作中使用 ESM,请引用以下之一:
ESMC、SAE 和 ESMFold2
@misc{candido2026language,
  title  = {Language Modeling Materializes a World Model of Protein Biology},
  author = {Candido, Salvatore and Hayes, Thomas and Derry, Alexander and Rao, Roshan
            and Lin, Zeming and Verkuil, Robert and Wu, Bryan and Lee, Jin Sub
            and Bruguera, Elise S. and Keval, Jehan A. and Kopylov, Mykhailo
            and Pak, John E. and Wu, Wesley and Thomas, Neil and Mataraso, Samson
            and Hsu, Alvin and Trotman-Grant, Ashton C. and Fatras, Kilian
            and dos Santos Costa, Allan and Badkundri, Rohil and Ak{\i}n, Halil
            and Oktay, Deniz and Deaton, Jonathan and Montabana, Elizabeth
            and Sitwala, Hrishita and Yu, Yue and Wiggert, Marius
            and Carlin, Dylan Alexander and Goering, Anthony W. and Blazejewski, Tomasz
            and Sandora, McCullen and Hla, Michael and Jia, Tina Z.
            and Kloker, Leon H. and Sofroniew, Nicholas J. and Uehara, Masatoshi
            and Pannu, Jassi and Bachas, Sharrol and Liu, Daniel S.
            and Sercu, Tom and Rives, Alexander},
  year   = {2026},
  url    = {https://biohub.ai/papers/esm_protein.pdf},
  note   = {Preprint}
}
ESM3
@article {hayes2024simulating,
	author = {Hayes, Thomas and Rao, Roshan and Akin, Halil and Sofroniew, Nicholas J. and Oktay, Deniz and Lin, Zeming and Verkuil, Robert and Tran, Vincent Q. and Deaton, Jonathan and Wiggert, Marius and Badkundri, Rohil and Shafkat, Irhum and Gong, Jun and Derry, Alexander and Molina, Raul S. and Thomas, Neil and Khan, Yousuf A. and Mishra, Chetan and Kim, Carolyn and Bartie, Liam J. and Nemeth, Matthew and Hsu, Patrick D. and Sercu, Tom and Candido, Salvatore and Rives, Alexander},
	title = {Simulating 500 million years of evolution with a language model},
	year = {2025},
	doi = {10.1126/science.ads0018},
	URL = {http://dx.doi.org/10.1126/science.ads0018},
	journal = {Science}
}
ESM Github(代码/权重)
@software{evolutionaryscale_2024,
  author = {{EvolutionaryScale Team}},
  title = {evolutionaryscale/esm},
  year = {2024},
  publisher = {Zenodo},
  doi = {10.5281/zenodo.14219303},
  URL = {https://doi.org/10.5281/zenodo.14219303}
}