whichllm

自动检测本地GPU/CPU/RAM,从HuggingFace实时筛选并排序最适合你硬件的本地LLM模型。亮点在于不只看参数大小,而是综合LiveBench、Aider等多种权威基准和速度估算做权重排名,同时支持一键运行和Python代码片段生成。适合想跑本地模型但不知选哪个的用户,直接终端运行即可获得推荐。
README
whichllm


找到真正能在你硬件上运行的最佳本地 LLM(大语言模型)。
自动检测你的 GPU/CPU/RAM,并从 HuggingFace 中筛选出适合你系统的顶级模型。
快速开始
运行一次推荐命令,无需项目设置。
uvx whichllm@latest
在购买硬件前模拟某个 GPU。
uvx whichllm@latest --gpu "RTX 4090"
经常使用时安装它。
uv tool install whichllm
uv tool upgrade whichllm  # 更新已安装版本
其他安装方式。
brew install andyyyy64/whichllm/whichllm
pip install whichllm
常见工作流
安装后,直接运行 whichllm。单次运行时,将 whichllm 替换为 uvx whichllm@latest。
# 本机最佳模型
whichllm

# 假设你拥有特定 GPU
whichllm --gpu "RTX 4090"

# 比较升级候选方案
whichllm upgrade "RTX 4090" "RTX 5090" "H100"

# 查找运行某模型所需的 GPU
whichllm plan "llama 3 70b"

# 与模型开始聊天
whichllm run "qwen 2.5 1.5b gguf"

# 打印可直接复制使用的 Python 代码
whichllm snippet "qwen 7b"

# 返回 JSON 供脚本使用
whichllm --top 1 --json
效果预览
$ whichllm --gpu "RTX 4090"

#1  Qwen/Qwen3.6-27B     27.8B  Q5_K_M   score 92.8    27 t/s
#2  Qwen/Qwen3-32B       32.0B  Q4_K_M   score 83.0    31 t/s
#3  Qwen/Qwen3-30B-A3B   30.0B  Q5_K_M   score 82.7   102 t/s
32B 模型 在你的显卡上完全可用——但 whichllm 仍然将 27B 排在 #1,因为它在真实基准测试中得分更高,且是新一代模型。单纯“什么能塞进去”的工具会给你更大的那个。这个差距正是 whichllm 的价值所在。(注意 #3:一个 MoE(混合专家)模型,速度 102 t/s——速度按活跃参数排名,质量按总参数排名。)
我能运行什么?
真实最佳推荐(快照 2026-05——你的结果会追踪实时的 HuggingFace 数据,这不是静态列表):
| 硬件 | VRAM | 最佳推荐 | 速度 |
|---|---|---|---|
| RTX 5090 | 32 GB | Qwen3.6-27B · Q6_K · score 94.7 |
~40 t/s |
| RTX 4090 / 3090 | 24 GB | Qwen3.6-27B · Q5_K_M · score 92.8 |
~27 t/s |
| RTX 4060 | 8 GB | Qwen3-14B · Q3_K_M · score 71.0 |
~22 t/s |
| Apple M3 Max | 36 GB | Qwen3.6-27B · Q5_K_M · score 89.4 |
~9 t/s |
| 仅 CPU | — | gpt-oss-20b (MoE) · Q4_K_M · score 45.2 |
~6 t/s |
whichllm --gpu "<your card>" 可以在购买前模拟以上任意配置。
为什么选择 whichllm?
把模型塞进你的 VRAM 是容易的部分。难的是知道哪些能塞进去的模型实际上是最好的——这正是 whichllm 要解决的问题。
- 基于证据的排名,而非大小启发式——最佳选择来自合并的真实基准(LiveBench、Artificial Analysis、Aider、多模态/视觉、Chatbot Arena ELO、Open LLM Leaderboard),绝不仅仅是“刚好能塞进去的最大模型”。
- 时效感知——过时的排行榜会随着每个模型的谱系而降权,因此一个 2024 年的模型无法利用过时的分数超越当前代模型。基准快照日期会在每次排名下打印,因此过时的推荐一目了然,不会被默默信任。
- 证据分级与防护——每个分数都带有
direct/variant/base/interpolated/self-reported标签,并按置信度打折。虚假的上传者声明以及跨家族继承(一个小型分支借用其大很多倍的基座模型的分数)会被主动拒绝。 - 架构感知估算——VRAM = 权重 + GQA KV 缓存 + 激活 + 开销;速度受带宽限制,并包含每个量化级别的效率、每个后端的因素、MoE 活跃参数 vs 总参数、以及统一内存 vs 离散 PCIe 部分 offload 模型。
- 单命令,可脚本化——
whichllm直接输出答案;添加--json | jq用于管道。无 TUI,无需记忆快捷键。 - 实时数据——模型直接从 HuggingFace API 获取,并备有经过筛选的冻结后备数据,用于离线或限流场景。
功能特性
- 自动检测硬件——NVIDIA、AMD、Apple Silicon、仅 CPU
- 智能排名——根据 VRAM 适配性、速度和基准质量对模型打分
- 一键聊天——
whichllm run下载并立即启动聊天会话 - 代码片段——
whichllm snippet为任何模型打印可直接运行的 Python 代码 - 实时数据——直接从 HuggingFace 获取模型(缓存以提升性能)
- 基准感知——整合真实评估分数,并带有置信度压缩
- 任务配置——按通用、编码、视觉或数学用例过滤
- GPU 模拟——使用任意 GPU 测试:
whichllm --gpu "RTX 4090" - 硬件规划——反向查询:
whichllm plan "llama 3 70b" - 升级规划——比较当前机器与候选 GPU
- JSON 输出——适合管道:
whichllm --json
运行与代码片段
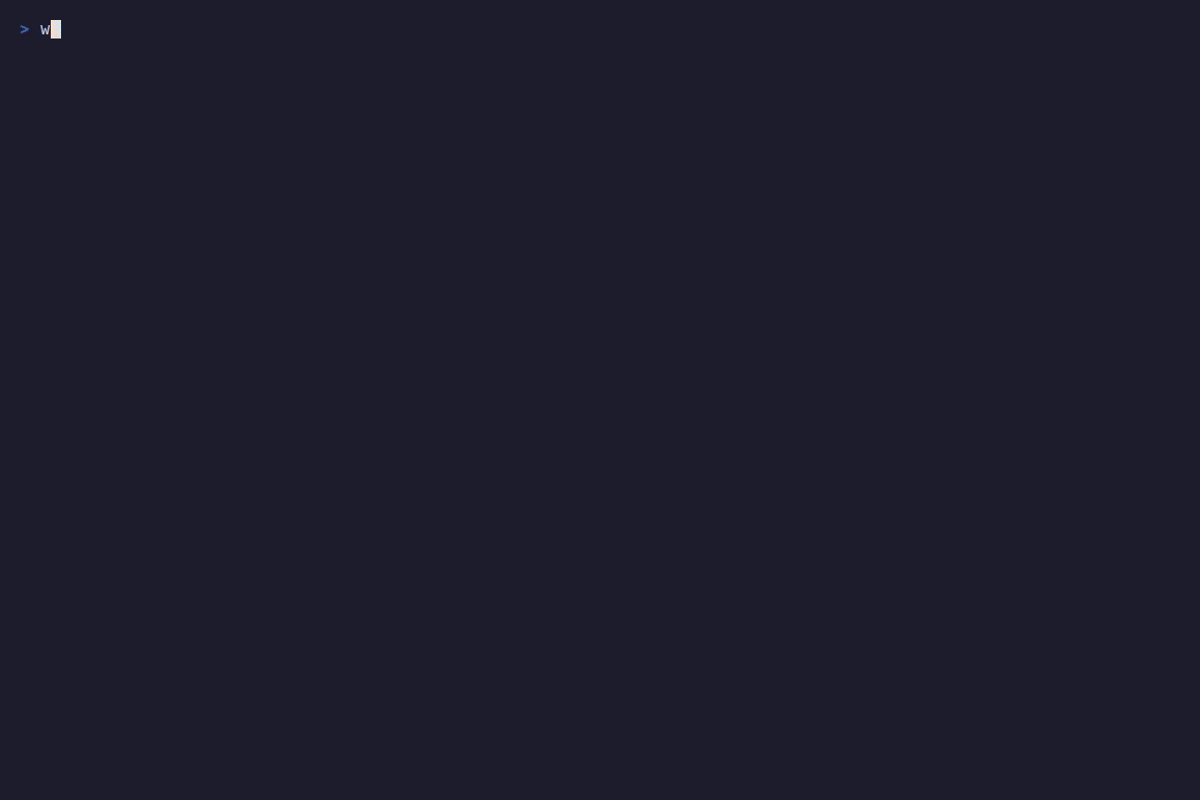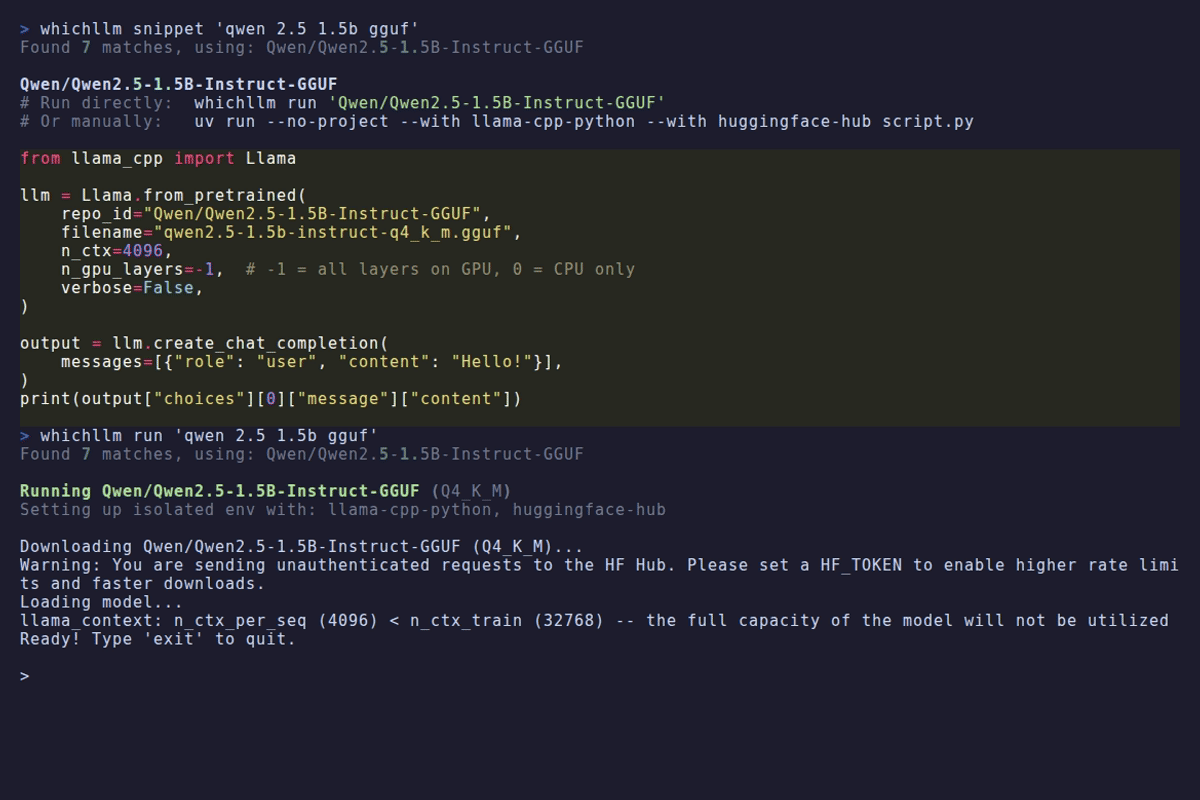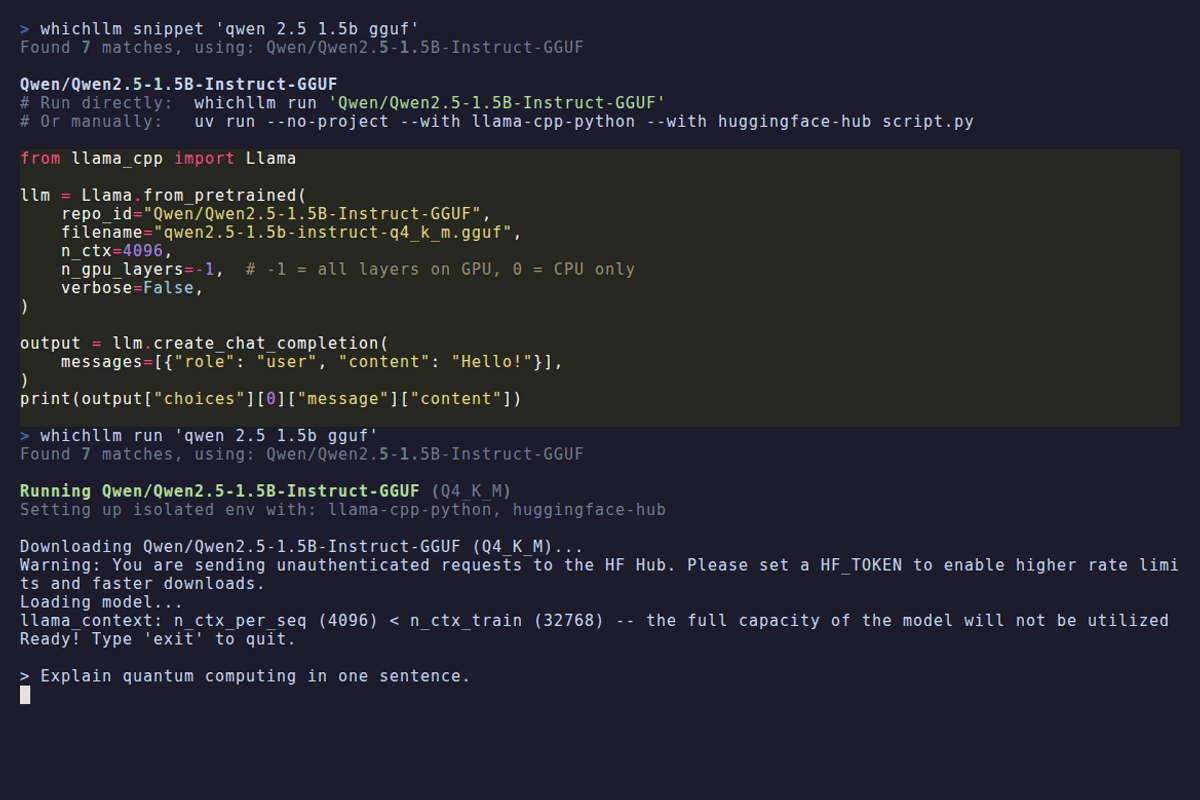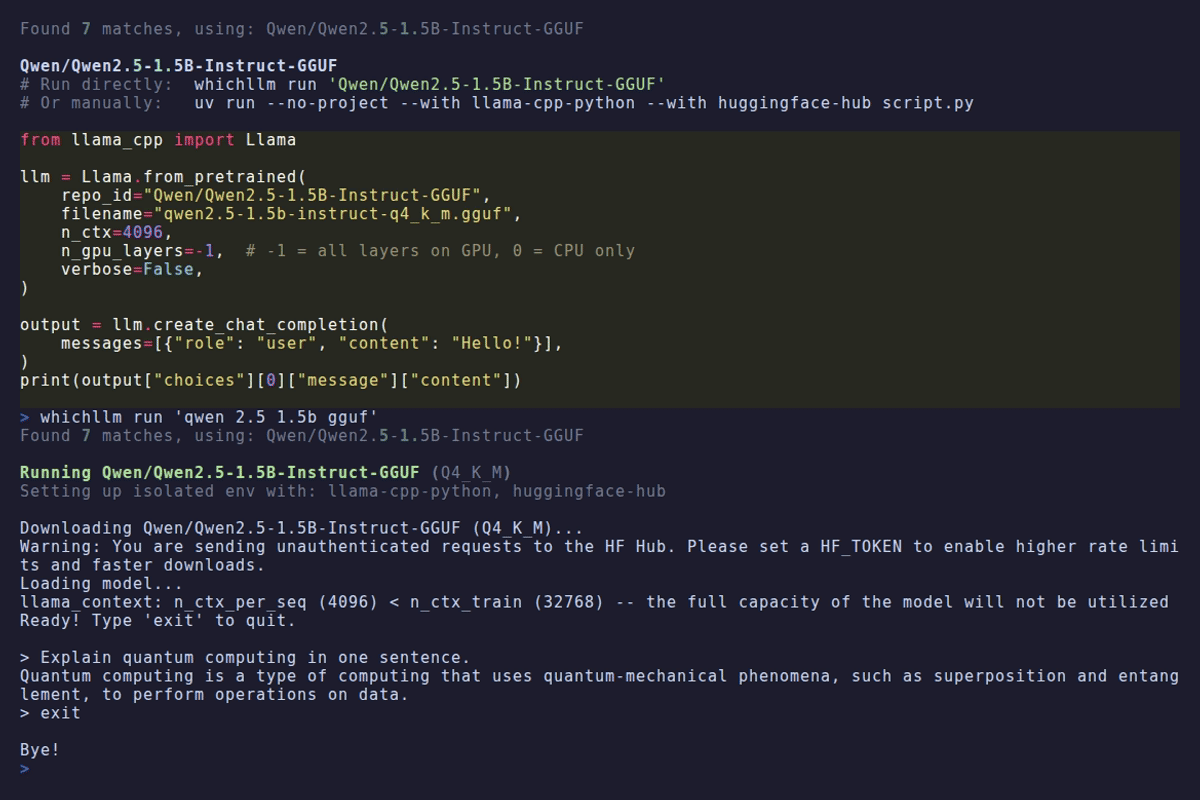
使用单个命令尝试任意模型。无需手动安装——whichllm 通过 uv 创建隔离环境,安装依赖,下载模型,并启动交互式聊天。
# 与模型聊天(自动选择最佳的 GGUF 变体)
whichllm run "qwen 2.5 1.5b gguf"

# 自动选择最适合你硬件的模型并聊天
whichllm run

# 仅 CPU 模式
whichllm run "phi 3 mini gguf" --cpu-only
支持所有模型格式:
- GGUF——通过
llama-cpp-python(轻量、快速) - AWQ / GPTQ——通过
transformers+autoawq/auto-gptq - FP16 / BF16——通过
transformers
获取可直接粘贴使用的 Python 代码片段:
whichllm snippet "qwen 7b"
from llama_cpp import Llama

llm = Llama.from_pretrained(
    repo_id="Qwen/Qwen2.5-7B-Instruct-GGUF",
    filename="qwen2.5-7b-instruct-q4_k_m.gguf",
    n_ctx=4096,
    n_gpu_layers=-1,
    verbose=False,
)

output = llm.create_chat_completion(
    messages=[{"role": "user", "content": "Hello!"}],
)
print(output["choices"][0]["message"]["content"])
用法
# 自动检测硬件并显示最佳模型
whichllm

# 模拟 GPU(例如计划购买时)
whichllm --gpu "RTX 4090"
whichllm --gpu "RTX 5090"
# 指定变体
whichllm --gpu "RTX 5060 16"

# 仅 CPU 模式
whichllm --cpu-only

# 更多结果 / 过滤
whichllm --top 20
whichllm --quant Q4_K_M
whichllm --min-speed 30
whichllm --evidence base   # 允许 id/base-model 匹配
whichllm --evidence strict # 仅 id 完全匹配(同 --direct)
whichllm --direct

# JSON 输出
whichllm --json

# 强制刷新(忽略缓存)
whichllm --refresh

# 仅显示硬件信息
whichllm hardware

# 规划:运行某个模型需要什么 GPU?
whichllm plan "llama 3 70b"
whichllm plan "Qwen2.5-72B" --quant Q8_0
whichllm plan "mistral 7b" --context-length 32768

# 升级:比较当前机器与候选 GPU
whichllm upgrade "RTX 4090" "RTX 5090" "H100"
whichllm upgrade "Apple M4 Max" --top 5

# 运行:下载模型并立即聊天
whichllm run "qwen 2.5 1.5b gguf"
whichllm run                       # 自动选择最适合你硬件的模型

# 代码片段:打印可直接运行的 Python 代码
whichllm snippet "qwen 7b"
whichllm snippet "llama 3 8b gguf" --quant Q5_K_M
JSON 模型行包括 estimated_tok_per_sec、speed_confidence、speed_range_tok_per_sec 和 speed_notes。速度范围是规划范围,而非实时基准。
集成
Ollama
使用 JSON 输出将 HuggingFace ID 映射到你本地的 Ollama 模型名称:
# 选择排名最高的 HuggingFace 模型 ID
whichllm --top 1 --json | jq -r '.models[0].model_id'

# 找到最佳的编码模型 ID
whichllm --profile coding --top 1 --json | jq -r '.models[0].model_id'
Ollama 模型名称并不总是与 HuggingFace 仓库 ID 匹配,因此在 ollama run 之前通常需要一个小的映射步骤。
Shell 别名
添加到你的 .bashrc / .zshrc:
alias bestllm='whichllm --top 1 --json | jq -r ".models[0].model_id"'
# 用法:ollama run $(bestllm)
评分机制
每个模型获得 0-100 分。基准质量和模型大小构成核心;证据置信度和运行时适配性对其进行伸缩,速度、来源可信度和流行度作为调整项。
| 因素 | 影响 | 描述 |
|---|---|---|
| 基准质量 | 核心 | 合并的 LiveBench / Artificial Analysis / Aider / Vision / Arena ELO / Open LLM Leaderboard,按来源置信度加权 |
| 模型大小 | 最高 35 | 基于 log2 缩放的世界知识代理(MoE 使用总参数) |
| 量化 | × 惩罚 | 低位量化按乘法打折 |
| 证据置信度 | ×0.55–1.0 | 无 / 自称 ×0.55,继承 ×0.78,直接满分 |
| 运行时适配性 | ×0.50–1.0 | 部分 offload ×0.72,仅 CPU ×0.50 |
| 速度 | -8 到 +8 | 可用性门槛 vs 基于适配性的 tok/s 下限;附带置信度和范围元数据 |
| 来源可信度 | -5 到 +5 | 官方组织加分,已知重新打包者扣分 |
| 流行度 | 平局决胜 | 下载量 / 点赞;随证据强度增加而权重减少 |
分数标记:
~(黄色)——无直接基准;分数从模型家族继承 / 插值!sr(亮黄色)——仅上传者报告基准,未经独立验证?(红色)——无可用基准数据
--status 中的速度标记:
~(黄色)——有估算的 tok/s 范围?(红色)——低置信度速度估算;后端 / 运行时敏感性高
文档
工作原理
数据管道
模型获取——从 HuggingFace API 获取热门模型:
- 文本生成(按下载量 + 最近更新)
- GGUF 过滤(单独查询以覆盖)
- 视觉模型(
image-text-to-text)当--profile vision或any时
基准来源——当前层级(LiveBench、Artificial Analysis Index、Aider)在可访问时合并实时数据,外加精选的多模态 / 视觉索引;冻结层级(Open LLM Leaderboard v2、Chatbot Arena ELO)。层级有独立的封顶和谱系感知的时效降权,因此过时的排行榜不会继续奖励旧世代模型。
基准证据——五个解析级别,递增打折:
direct——精确模型 ID 匹配variant——去除后缀或 -Instruct 变体base_model——来自 cardData 的基座模型line_interp——模型家族内按大小感知插值self_reported——上传者声称的评估(严重打折)
当一个模型的参数量与其家族主导成员差异超过 2 倍时,继承将被拒绝,从而捕获那些共享
family_id但参数量远小于家族基座的分支(如 draft/MTP/abliterated 分支)。缓存——
~/.cache/whichllm/:models.json——6 小时 TTLbenchmark.json——24 小时 TTL
排名引擎
- 硬件检测——NVIDIA(nvidia-ml-py)、AMD(dbgpu/ROCm)、Apple Silicon(Metal)、CPU 核心、RAM、磁盘
- VRAM 估算——权重 + KV 缓存 + 激活 + 框架开销(约 500MB)
- 兼容性——完全 GPU / 部分 Offload / 仅 CPU;计算能力和操作系统检查
- 速度——根据 GPU 内存带宽、量化、后端、适配类型和 MoE 活跃参数计算的 tok/s
- 评分——基准(含置信度压缩)、大小、量化惩罚、适配类型、速度、流行度、来源可信度(官方 vs 重新打包者)
- 后端过滤——Apple Silicon 和仅 CPU 限制为 GGUF 以保持稳定性;Linux+NVIDIA 允许 AWQ/GPTQ
项目结构
src/whichllm/
├── cli.py              # Typer CLI:main, plan, run, snippet, hardware
├── constants.py        # GPU 带宽、量化字节、计算能力
├── hardware/
│   ├── detector.py     # 编排 GPU/CPU/RAM 检测
│   ├── nvidia.py       # NVIDIA GPU 通过 nvidia-ml-py
│   ├── amd.py          # AMD GPU (Linux)
│   ├── apple.py        # Apple Silicon (Metal)
│   ├── cpu.py          # CPU 名称、核心、AVX 支持
│   ├── memory.py       # RAM 和磁盘空余
│   ├── gpu_simulator.py # --gpu 标志:根据名称合成的 GPU
│   └── types.py        # GPUInfo, HardwareInfo
├── models/
│   ├── fetcher.py      # HuggingFace API、模型解析、evalResults
│   ├── benchmark.py    # Arena ELO、Leaderboard(parquet/rows API)
│   ├── grouper.py      # 按 base_model 和名称的家族分组
│   ├── cache.py        # 带 TTL 的 JSON 缓存
│   └── types.py        # ModelInfo, GGUFVariant, ModelFamily
├── engine/
│   ├── vram.py         # VRAM = 权重 + KV 缓存 + 激活 + 开销
│   ├── compatibility.py# 适配类型、磁盘检查、计算/操作系统警告
│   ├── performance.py  # 根据带宽计算的 tok/s
│   ├── quantization.py # 每权重的字节数、质量惩罚、非 GGUF 推理
│   ├── ranker.py       # 评分、证据过滤、配置/匹配
│   └── types.py        # CompatibilityResult
└── output/
    └── display.py      # Rich 表格、JSON 输出、硬件/计划显示
开发
git clone https://github.com/Andyyyy64/whichllm.git
cd whichllm
uv sync --dev
uv run whichllm
uv run pytest
贡献
欢迎贡献!请参阅 CONTRIBUTING.md 了解指引。
支持
如果 whichllm 帮你找到了合适的模型或避免了错误的硬件猜测,赞助将非常感谢。这有助于项目维护:硬件报告、打包、测试夹具、基准更新以及支持更多机器。
无论如何,whichllm 将保持开源。问题和 PR 始终欢迎。
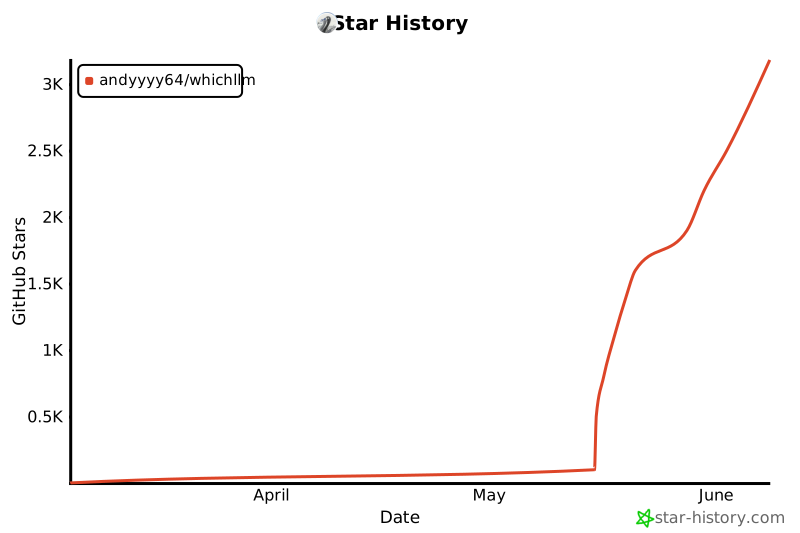
有用的话,点个 GitHub Star 可以帮助其他人找到它,我也很想知道它为你推荐的配置。可以在 Issues 中分享。
Star 历史
要求
- Python 3.11+
- NVIDIA GPU 检测通过
nvidia-ml-py(默认包含) - AMD / Apple Silicon 自动检测
许可证
MIT